在传统微服务中,Round robin、power of two choices 等策略普遍有效,因为无状态的同构实例近似等价,router 只需判断谁更空闲。到了 LLM Serving,动态 batching 和未知的生成长度让请求成本难以预估。Prefix Cache 又让同一请求落到不同实例时产生不同的推理成本。因此,router 既要估算负载,也要考虑 cache 复用。
Prefix Cache 给每个实例带来了一份超大、易失、局部的性能状态。router 既要在排队、重算和通信之间权衡,也要考虑这次选择会怎样改变后续请求看到的 cache 分布。每次选择都依据当前状态,也会改变下一次选择的条件。
KV Cache 作为一种状态
LLM 请求之间经常共享前缀。固定的 system prompt、相同文档,以及 agent 反复携带的上下文,都可能形成大量重复前缀。Prefix Cache 保存这些前缀已经算好的 KV Cache。新请求命中连续前缀后,只需计算未命中的尾部。
KV Cache 只影响性能,不影响请求结果。即使 router 判断错了 cache 位置,实例仍可重新计算,代价只是更高的 TTFT。Cache 可以丢失,router 也可以依据最终一致性做决策,无需引入分布式事务。
Prefix Cache 与 session affinity 这种 1:1 映射也有差别。Session affinity 通常把一个 key 绑定到一个 owner,但 Prefix Cache 则具有层次关系。同一个 system prompt 可以是许多会话的共同祖先,同一前缀也可能同时存在于多个实例。router 面对的实例状态存在重叠,同时也是动态的,历史 Cache 可能随时被淘汰。
Hit rate 不是最终目标
把同一前缀的请求全部集中到单一实例,通常可以得到更高的 hit rate,但也可能因为排队而抬高 TTFT。用户感受到的是响应时间,服务端真正关心的是 SLO goodput。Hit rate 和实例间负载差都是中间指标。
Prefix Cache 的生命周期符合一个典型的有状态 Cache 服务。一个前缀第一次出现时,集群里没有任何实例持有它。请求完成 Prefill 后,承接请求的实例留下第一份 cache,后续请求可以复用这份 cache。流量超过单台实例的承载能力时,部分请求会逃逸到其他实例,形成更多副本。随着 LRU 淘汰、实例重启或扩缩容,副本又会减少,甚至重新归零。这样的循环会贯穿服务的整个运行过程。
完整的路由策略要持续回答三个问题。
第一,如何判断 cache 在哪里。通常有依赖实例上报、路由历史记录、稳定 hash 算法三种,各自信息的准确度和维护成本不同。
第二,如何比较请求发往不同实例的成本。如果优化目标为 TTFT,那么记输入长度为 ,实例 的连续命中 token 数为 ,可以把目标写成:
这里既要估计实例已有任务的剩余执行时间,也要估计未命中部分的 Prefill 时间。工程实现很难准确得到两个量,通常会使用活跃请求数、token backlog、inflight ledger 或 KV 压力等信号近似。
第三,这次选择会怎样改变后续的副本分布。全冷时由哪台实例产生第一份副本,过载时允许产生多少副本,淘汰以后如何重新建立副本,都由同一套策略决定。如果完全不限制副本数量,cache 会随负载逃逸逐渐扩散,消耗整体 Cache 容量。反过来,亲和性过强又会形成热点。router 只能决定新请求是否产生副本,已有副本仍要由实例内的 eviction 回收,因此副本分布只能随后续请求逐步变化。路由策略需要在两者之间取舍。
路由策略由轻到重:负载、前缀亲和、真实 cache
下面按 router 使用的信息分成三层。越往下,状态判断越准确,控制面也越重。
第一层:不感知 cache,只按负载分流
Round robin、least-load 和 power of two choices 不区分冷前缀与已有 cache。同一冷前缀的并发请求可能被分到多台实例,并各自生成一份 cache。后续路由仍然忽略这些副本,Cache 淘汰也不会改变路由行为。Cache 从未进入决策。
这类策略的优势是状态少,无需处理 cache 上报、请求记录和 LRU 淘汰后的视图更新。在前缀复用率很低、输入很短、Cache 存储容量极大的场景里,它们的效果可能与复杂策略基本接近。
第二层:用 hash 或历史建立前缀亲和
这类策略不查询实例当前持有哪些 cache,而是由 router 计算或记住同一前缀应该发往哪台实例。这样可以把请求集中到较少的实例上。Prefix hash 和历史 radix tree 的区别,在于前缀亲和关系如何建立和维护。
Prefix hash:第一次请求前就有 home
SGLang 的 prefix_hash 默认对前 256 个 token 做一致性哈希,为每个前缀计算一个稳定 home。前缀还没有 cache 时,第一个请求就会去 home,并在那里产生副本。有 cache 以后,相同 key 继续回到同一实例。它不需要等待一次历史路由,也不依赖实例上报 cache 状态。
当 home 的活跃请求数超过全局平均值的 1.25 倍,router 会把新请求改发到全局负载最低的实例,避免原 home 的队列继续增长。新实例完成 Prefill 后也会留下一份 cache。由于 least-loaded 没有固定的第二 home,持续过载仍可能把副本扩散到更多实例。
实例淘汰 cache 后,hash 结果不会改变,下一个请求仍会回到原 home,重新计算并恢复副本。只要多个 router 使用相同的实例列表和健康状态,它们就能各自算出相同的 home。另外,使用带虚拟节点的一致性哈希环,实例扩缩容时只有部分 key 的 home 会改变。不过,旧 cache 不会随映射自动搬走或删除。
关键参数是参与 hash 的前缀长度:太短容易形成 hot key,太长又会打散本可共享的前缀。
历史 radix tree:第一次路由后形成 owner
SGLang 的 cache_aware 在 router 本地维护 radix tree。router 第一次看到某个前缀时,先把请求发给当前负载最低的实例,并把前缀与实例写入树中。只要实例间的负载差没有同时超过绝对阈值和相对阈值,后续同前缀请求就继续发往这台实例。一旦超过阈值,router 就会改选活跃请求最少的实例,新实例也会留下一份 cache。
Radix tree 记住的是 router 自己做过的选择,并不知道实例中是否还有对应 cache。原实例淘汰 cache 或发生重启时,tree 不会立即更新,后续请求仍可能被发回原实例并重新计算。部署多个 router 副本时,还要维护这些 tree 的一致性,否则不同 router 会得到不同的历史 owner。
第三层:读取实际 cache 分布,再比较等待与重算
router 根据实例上报的信息维护 cache 索引,由此找到持有前缀的实例。不过,即使某台实例已有 cache,排队时间也可能比重新计算更长。router 还要比较 cache 节省的计算量和排队时间,判断哪个实例的预估 TTFT 更低。
vLLM loadaware:用命中比例和请求数估算
vLLM Production Stack 的 loadaware 根据命中比例与相对活跃请求数为实例打分:
loadaware 选择 最大的实例。第一项表示当前请求可复用的前缀比例;第二项表示实例的活跃请求数相对集群平均值高出多少,其中 包括 Prefill 和 Decode 请求, 决定 router 愿意牺牲多少 cache 命中来换取更均衡的负载。Cache-hot 实例上的请求越多,负载惩罚越大。超过某个点后,空闲的冷实例会胜出,热点不再持续堆在同一实例上。
实验观察到1,当 时,最忙与最闲实例的 running-request ratio 从基准 kvaware 的 2.358 降到 loadaware 的 1.249,hit rate 从 91.2% 降到 90.7%。这意味着负载项只用 0.5 个百分点的 hit rate 就换来了更小的负载倾斜。
不过上述公式的归一化操作会忽视绝对规模带来的影响。 只保留命中比例,500/500 和 4000/4000 都记为完整命中,实际节省的计算量却相差很大。活跃请求数同样无法区分长短 Prefill、刚开始与即将结束的 Decode,还把 Prefill 和 Decode 混在同一个计数里,尽管它们所代表的工作量非常不同。
一种直接的改写是把负载信号从活跃请求数 换成 token-equivalent backlog ,其余结构保持不变:
这里只有第二项发生了变化:一个活跃请求不再统一记作 1,而是按 token 工作量计入 backlog。这样至少能区分长短 Prefill 请求,但仍是归一化分数,不好估算真实执行时间。
FlexLB:把 Prefill、排队和组 batch 统一成时间
FlexLB 的 Prefill 策略 采用 least workload 的选择思路。它读取实例上报的 block 信息,估算当前请求扣除 cache 收益后的 Prefill 时间,再加上已有 Prefill 的剩余时间和 router 组 batch 的等待时间,得到实例成本 :
FlexLB 以最低 为基准,在分数接近的实例中均匀随机选择。
由 PrefillTimePredictor 给出。默认的 FormulaPredictor 使用以下公式:
公式结果直接作为毫秒数,相当于把每个未命中 token 记为 1 ms,每个命中 token 记为 0.3 ms。单个请求下为 。相比 loadaware,它保留了绝对 token 工作量,但系数需要根据模型、硬件和 workload 人工校准。
估算实例 尚未完成的 Prefill 工作。令 表示这些 inflight batch, 表示 batch 开始扣减运行时间的起点:
ledger 保存 batch 的预测耗时和 progressBase。如果预测耗时是 5 秒,batch 发出 150 ms 后才开始运行,到 200 ms 时只扣除 50 ms,剩余 4.95 秒。排队的 150 ms 不会被算作计算进度。
当前实现将多个 inflight batch 按串行方式聚合。假设两个 batch 都在 开始运行,预测耗时和实际耗时均为 5 秒,并且始终并行执行:
| 时刻 | 逐 batch 剩余时间之和 | 实际清空时间 | 公式估算 |
|---|---|---|---|
| 10 秒 | 5 秒 | 10 秒 | |
| 8 秒 | 4 秒 | 9 秒 | |
| ,完成状态尚未同步 | 0 秒 | 0 秒 | 5 秒 |
| 完成状态同步后 | 0 秒 | 0 秒 | 0 秒 |
在 时,公式得到的 9 秒相当于第一个 batch 剩余 4 秒,第二个 batch 仍按完整的 5 秒计算。如果两批都在推进,逐 batch 剩余时间之和应为 8 秒。这里的误差来自聚合公式采用了串行假设。只要多个 batch 会同时推进,inflight 聚合方式的估算就会偏大。完成状态同步后,router 删除对应的 ledger 记录,估算值归零。
偏差会随并行 batch 数量和运行时间增加,并非所有实例共有的固定值。只有各实例的并行情况接近时,偏差才可能在排序中抵消。否则会高估并行 batch 较多的实例。
是请求在 router WorkerBatcher 中的等待时间。实例在入队前已经选定,发送 batch 时不会重新选择。
默认的 fixed_window 以 为等待窗口。令 表示新请求到达前的队列长度, 表示最大 batch size, 表示队首请求的入队时间:
新请求补齐 batch 时立即发送。已有未满 batch 时计算窗口剩余时间。其他情况返回完整窗口。SLO-budget 和 Auto-TPM 分别改用 deadline 和优先级感知的估算。
所有实例都没有对应 cache 时,负载决定谁产生第一份副本。出现 cache 命中后, 会下降,排队则会抬高 。FlexLB 没有稳定 home,因此并发冷请求仍可能在 cache report 更新前落到不同实例,产生多份副本。
FlexLB LearningPredictor:用实测时间校准 Prefill 预测
相比 FormulaPredictor,LearningPredictor 用在线学习拟合 , 和 保持不变。
输入向量 由常数项 1 和 batch 的五项统计量组成:请求数 、命中 token 总量、未命中 token 总量、未命中长度平方和,以及命中量与未命中量的乘积和。
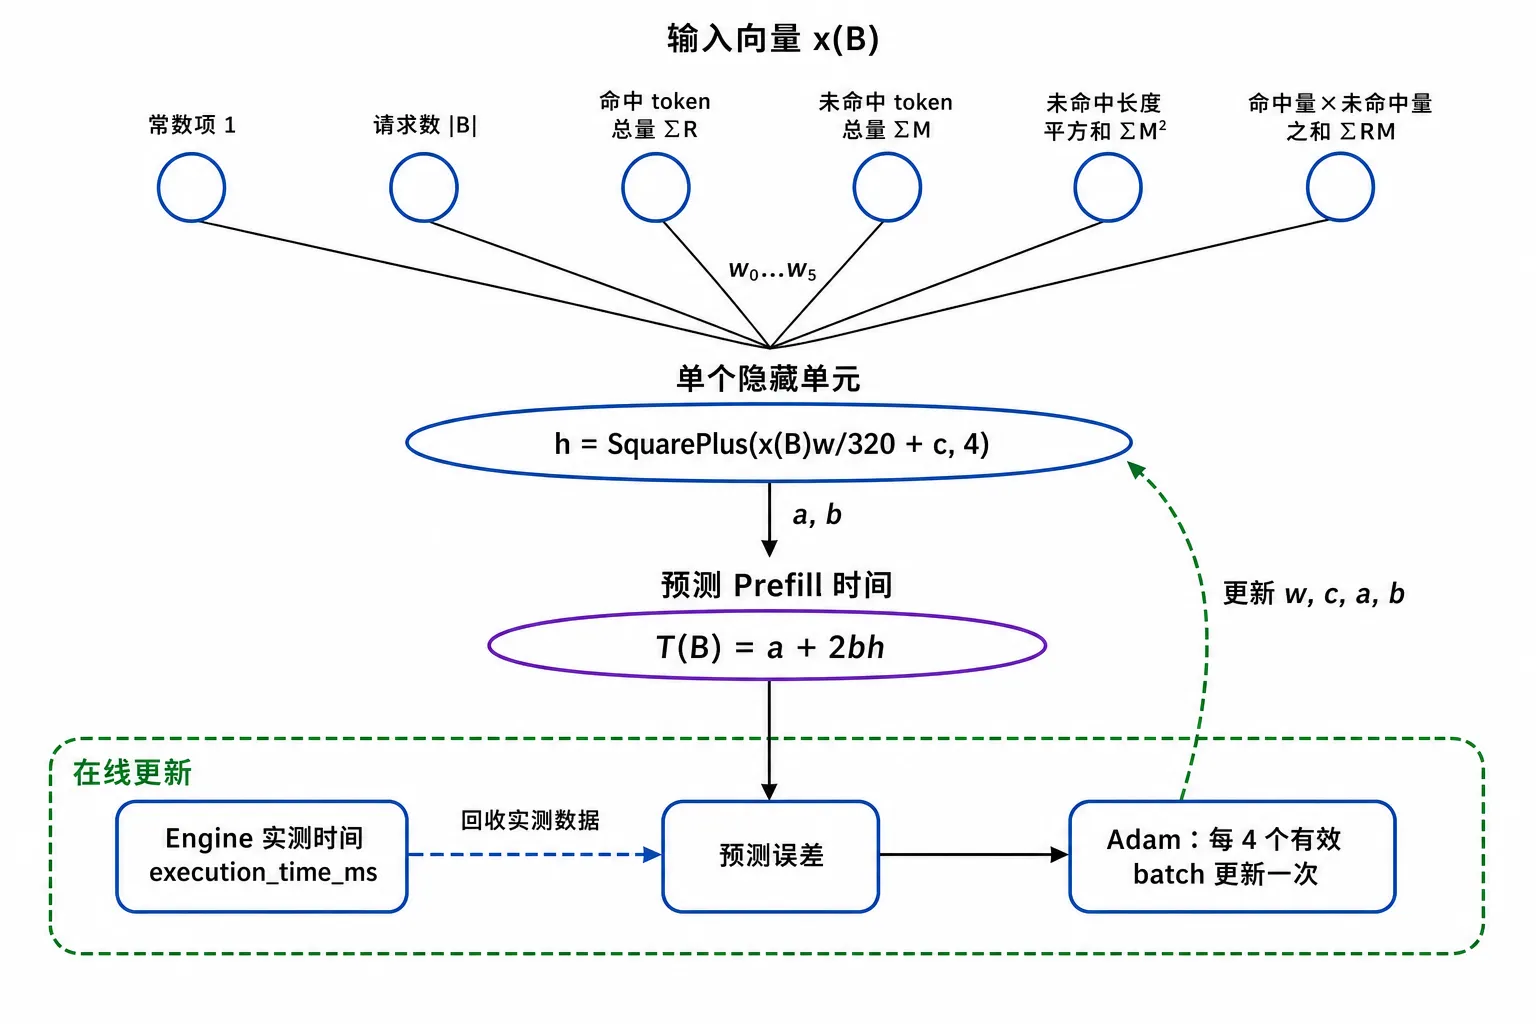
对于 batch 中的请求 ,,,图中的求和均遍历整个 batch。1024 和 320 只用于数值缩放,与 cache block size 无关。非线性由 SquarePlus2 激活函数提供。
模型共有 9 个可训练参数。实例上报的 execution_time_ms 是请求从进入实例到结束的时间减去排队时间,router 取 batch 内的最大值作为训练标签。每积累四个有效 batch,LearningPredictor 通过 Adam 更新一次参数。
它能适应模型、硬件和 workload 的差异。代价是需要积累样本,而且权重只保存在 router 内存中。进程重启或主从切换会丢失校准结果,多个 router 副本也不会同步参数。
Dynamo 与 llm-d:用 KV 事件维护 cache 索引
NVIDIA Dynamo3 和 llm-d4 也读取实例上报的 KV 状态,再用 cache overlap 和活跃负载共同选择实例。FlexLB 周期性接收完整 cache snapshot。Dynamo 和 llm-d 的精确模式采用事件驱动,消费实例发出的 KV 事件并增量更新 block 索引。
llm-d 还保留基于路由历史的近似模式。Dynamo 则分别计算 GPU、CPU、磁盘和共享 cache 的命中收益,让较慢存储层的命中获得更低权重。
Preble:把未来的 cache 价值纳入调度
Preble5 用全局 prefix tree 记录每个实例的 cache。选择实例时,它同时估算当前计算负载,以及为了接收新请求而淘汰 cache 所造成的未来重算成本。后者由被淘汰前缀的重算时间和历史复用率共同决定。
负载失衡时,Preble 会把后续请求转向空闲实例。单个前缀持续过热时,再复制对应子树。这样可以主动控制副本扩散,代价是维护全局 prefix tree、复用历史和硬件 profiling。AIBrix6 已经提供 prefix-cache-preble 实现。
Prefill 与 Decode 使用不同的负载信号
Prefill 与 Decode 不适合共用同一套分数。Prefill 关心可复用计算与 TTFT,Decode 关心持续 KV 占用、并发和接近容量上限的风险。PD 分离场景中,两侧应当各自使用与执行阶段匹配的信号。
Cache 索引越准确,维护成本越高
FlexLB 当前实现 由实例周期性上报完整 key 集合,router 对新旧集合做 diff,再更新 blockHash → instances 的倒排索引。
这套 cache 索引只能做到最终一致。router 可能以为某台实例仍有 cache,实际已经淘汰,结果是多做一次冷 Prefill。它也可能暂时不知道某份新 cache,错过一次命中。两种误差都不影响请求结果,但索引的新鲜度会直接影响 TTFT 和 GPU 成本。
相比全量 snapshot,Dynamo 和 llm-d 的事件驱动方式只发送变化量,但要处理丢事件、乱序、重连和 snapshot 补全。历史 radix tree 和 prefix hash 不维护实际 cache 索引,也省去了这套控制面。
实例上报的 block 是最近一次观测到的 cache 状态,hash home 是预期去向,历史 owner 是过去的路由记录。三者的更新速度和失效方式不同。
共享 KV Cache 让 cache 不再绑定实例
前面的路由策略之所以复杂,是因为每台实例保存的 cache 不同。router 既要找到持有前缀的实例,又要避免请求集中到少数 cache 较多的实例。类似传统分布式系统的实践,可以把 KV 存入分布式缓存介质,这样任意实例都可以使用同一段前缀,cache 状态也从实例私有变成集群共享。只要远程恢复足够快,router 就不必再维护 prefix 与实例的对应关系,可以优先按负载选择实例。本地 L1 命中仍然更快,但共享 cache 让它不再是唯一的复用路径。请求不再必须发往持有 cache 的实例,cache-aware routing 也可以随之简化。
CacheGen 验证了从远端加载 KV 可以比重算更快。以 Mistral-7B 的 LongChat 测试为例,context 中位数约为 9.4K tokens。CacheGen 对 KV 做分组差分和分层量化,再用无损算术编码生成 bitstream,最终数据量为 176 MB,对比方案为 622 MB,总体压缩比约为 3.5:1。论文没有给出量化后的中间大小,因此无法单独计算无损编码的压缩比。在三种模型和四个数据集上,当带宽为 3 Gbps 时,使用 CacheGen 加载 KV 的 TTFT 比重算低 68%~79%7。
Mooncake 比较了本地 cache 与共享 cache。实验使用 10 个 Prefill 节点,每个节点都能保存 3M tokens。在集群总容量相同的情况下,共享 cache 将命中率最高提高 136%,Prefill GPU 计算时间最多降低 48%8。
这条路径也已进入现有推理框架。SGLang HiCache 与 Mooncake 可以组成共享 L3,Dynamo router 则能识别这部分 cache。共享层中的命中不再属于某个 worker,因此多个实例可以获得相同的复用收益。
另外,共享远程 cache 不能让所有实例完全等价,不同实例的负载、排队时间甚至硬件仍然可能不同。远程路径稳定且足够快时,router 可以弱化本地 cache 亲和,主要按负载分流;远程恢复较慢时,仍要区分本地命中和共享命中,毕竟本地 L1 命中也省去了远端读取和 H2D,通常更快。
Prefill-as-a-Service 将 Prefill 交给远端
共享 cache 改变状态存放的位置,Prefill-as-a-Service 则改变计算的位置。router 将未命中前缀较长的请求交给远端 Prefill 集群,再把生成的 KV Cache 传回本地 Decode 集群。未命中前缀较短的请求继续在本地处理,避免远端传输。
router 的选择范围由此从实例扩大到集群。调度器还要结合带宽和 cache 分布,判断哪些长请求适合发往远端。论文的案例研究中,这套方案相对只使用本地同构集群的基线将吞吐提高 54%,P90 TTFT 降低 64%;按相同成本比较,吞吐提高约 15%9。
Prefill-as-a-Service 仍要根据 cache 分布选择 Prefill 集群和具体实例。无论是移动已有 cache,还是在远端生成新的 KV,最终都要承担数据传输,这部分开销不能忽视。多级 cache 的讨论见《KV Cache 的多级缓存》。
状态和路径成本确定后,router 还要决定请求路由到各实例的概率。候选过滤、概率设计与部署切流,见《Prefix Cache 路由:概率调度与平滑切流》。
参考资料
-
Barron, J. T., Squareplus: A Softplus-Like Algebraic Rectifier, 2021. arXiv:2112.11687 ↩
-
Srivatsa, V. et al., Preble: Efficient Distributed Prompt Scheduling for LLM Serving, 2024. arXiv:2407.00023 ↩
-
Liu, Y. et al., CacheGen: KV Cache Compression and Streaming for Fast Large Language Model Serving, SIGCOMM 2024. Paper ↩
-
Qin, R. et al., Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving, §5.1、§5.4.2–5.4.3, FAST 2025. Paper ↩
-
Qin, R. et al., Prefill-as-a-Service: KVCache of Next-Generation Models Could Go Cross-Datacenter, 2026. arXiv:2604.15039 ↩