推理并行就是把计算和状态分摊到多个设备,同时保证局部合起来仍等价于整体。本质是分治法和空间换时间,以突破单机算力和内存瓶颈。
超长预警⚠️
资源账本
单个 rank 的显存主要用于权重、激活和 Cache。算子临时空间、CUDA Graph、通信缓冲区等额外占用记为 :
权重在请求之间共享,激活随当前计算产生和释放,Cache 则跨 step 保留。三者的生命周期不同。
计算强度的分析方法见《Roofline 分析:瓶颈的判定与局限》。
权重
TP、PP 和 EP 都能减少单 rank 的权重存储。权重如何分片,要与各子层的实际并行方式对应。
Dense 权重
设模型参数量为 ,每个权重元素占 字节。若 TP 均匀切分层内权重,PP 均匀切分模型层,单 rank 权重近似为:
MoE 权重
MoE 只激活部分 experts,但部署时仍需存储全部 expert 权重,不能用激活参数量估算权重占用。Attention 等非专家权重、routed experts 和 shared experts 分别按各自的分片或复制方式统计。
Routed expert 权重由实际的 EP、MoE-TP 与 MoE-DP groups 决定。不同推理引擎对这些 groups 的定义并不相同,具体实现放在 EP 小节对比。
激活
激活是当前 forward 的中间结果,例如 hidden states、 和 FFN 中间结果。推理无需为 backward 保存所有层的激活,显存峰值取决于同一时刻需保留的张量。当前处理的总 token 数越多,中间结果通常越大。
激活占用还取决于执行方式。FlashAttention 分块计算,避免把完整的 Attention score 矩阵写入 HBM1。同样,分片后的结果若能直接进入下一步计算,就无需先拼接成完整张量。
KV Cache
Cache 保存后续 step 会重复使用的状态。/ 的临时投影结果与写入后的 KV Cache 按实际存储分别统计,同一块存储只计一次。MHA、GQA、MQA 通常缓存 、,MLA 通常缓存 compressed latent 和 RoPE 相关状态,混合或线性 Attention 还会维护其他状态,准确预估需要结合模型结构。
CP 可以沿序列位置切分这些状态;TP 下的 cache 可能切分,也可能复制,取决于完整的并行策略配置、模型结构和推理框架实现。
并行策略
TP 切分层内矩阵,PP 按模型层划分,CP 沿序列维切分,EP 按专家分配,DP 则复制权重,让不同副本处理不同请求。这些方式可以彼此组合。
下文统一用 表示 batch size、 表示序列长度、 表示 hidden state 的宽度,典型的 hidden state 为 。hidden state 的每个元素占 bytes。
| 策略 | 主要切分对象 | rank-local 状态 | 恢复完整语义的主要通信 | 首要收益 |
|---|---|---|---|---|
| TP | 层内权重矩阵、heads | 权重分片 | AllReduce | 单卡权重占用与计算量减少(被分摊) |
| PP | 连续 Transformer layers | 一段连续完整层 | hidden state | 单卡权重占用减少 |
| DP | 请求 | 模型或 Attention 副本 | Replica 无;DPA 跨组重排 hidden state | Replica 增加独立副本;DPA 解耦 FFN/Attention 并行度 |
| CP | 序列维 | 权重副本与 / 序列分片 | / blocks 交换或局部 Attention 结果归并 | 长序列计算量与 KV Cache 存储分摊 |
| EP | experts | 一组 expert 权重 | AllReduce 或 dispatch 与 combine | 单卡 expert 权重占用减少 |
TP:切分层内矩阵
收益:同时分摊权重与计算
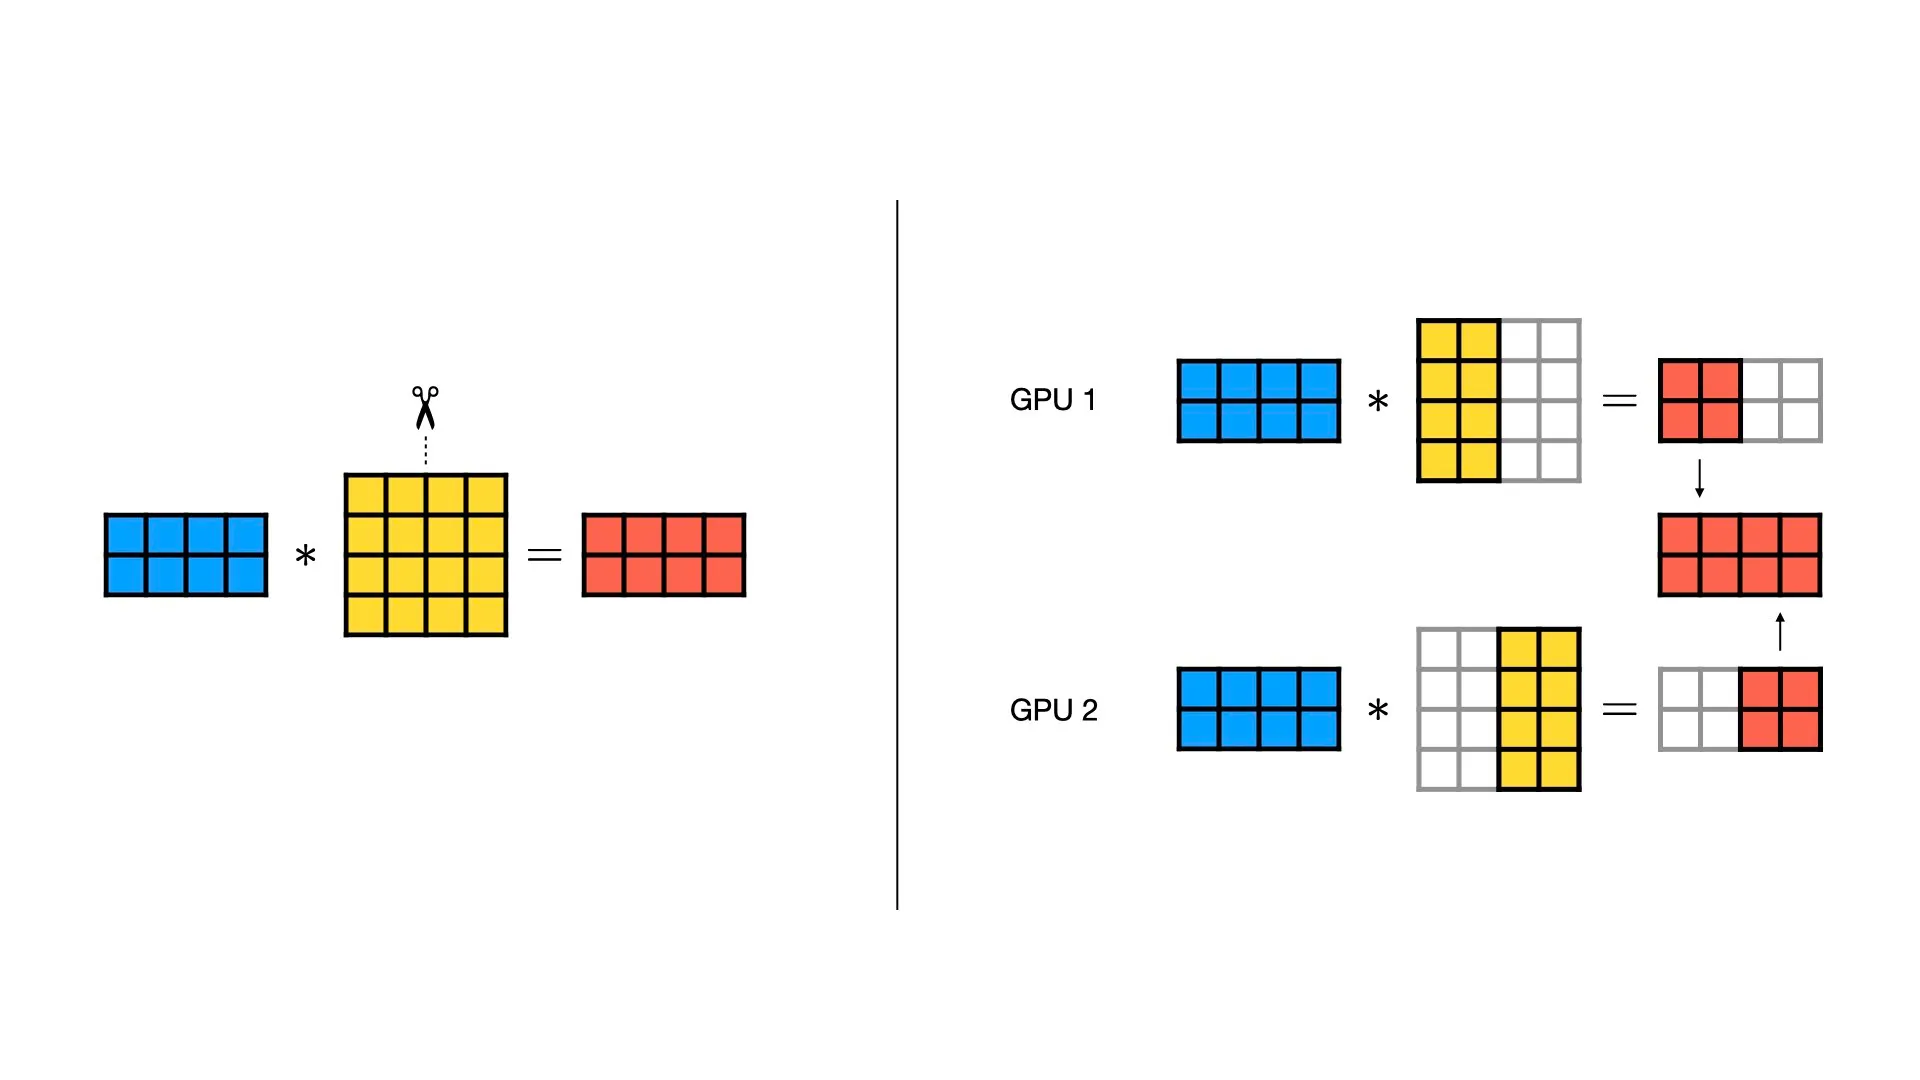
TP 沿层内矩阵切分 GEMM,让多个 ranks 参与同一次计算,能同时降低单个 rank 加载的权重与计算量。对如下矩阵:
沿输出维切分2时,各 rank 使用相同的输入 。第 个 rank 持有 ,算出不同的输出列:
每个 rank 只保存约 的权重并承担约 的 GEMM 计算量。注意,若后续运算可以独立作用于各输出分片,结果无需立即拼接。
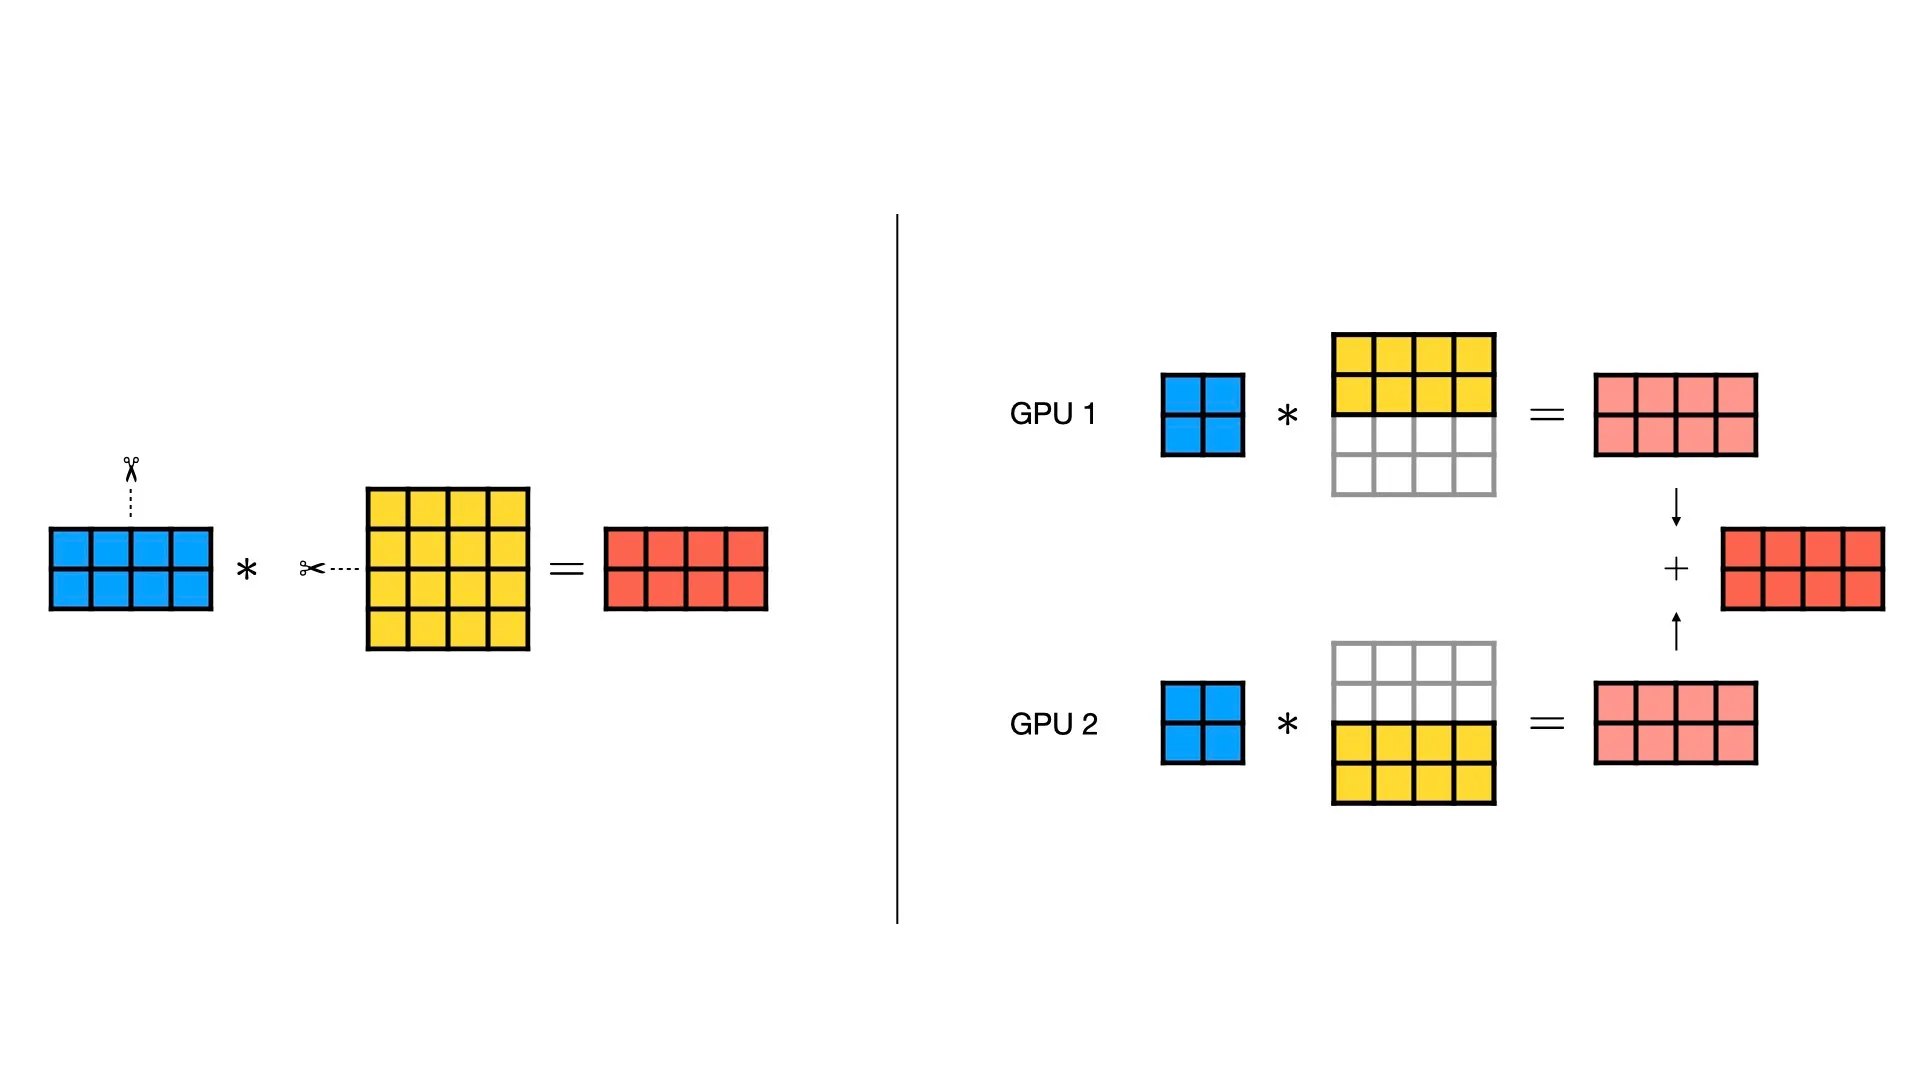
沿输入维切分时, 与 在收缩维 上切成对应的分片:
每个 rank 得到一个与输出 shape 相同的部分和:
各 来自不同的输入分片,却对应相同的输出位置,因此需要求和。若下一步每个 rank 都需要完整 ,就通过 AllReduce 归并。
矩阵连乘时,第一个 GEMM 的输出列正好是第二个 GEMM 的输入维。因此可以先沿输出维切分,让本地结果直接进入沿输入维切分的第二个 GEMM,直到产生部分和才通信归并。
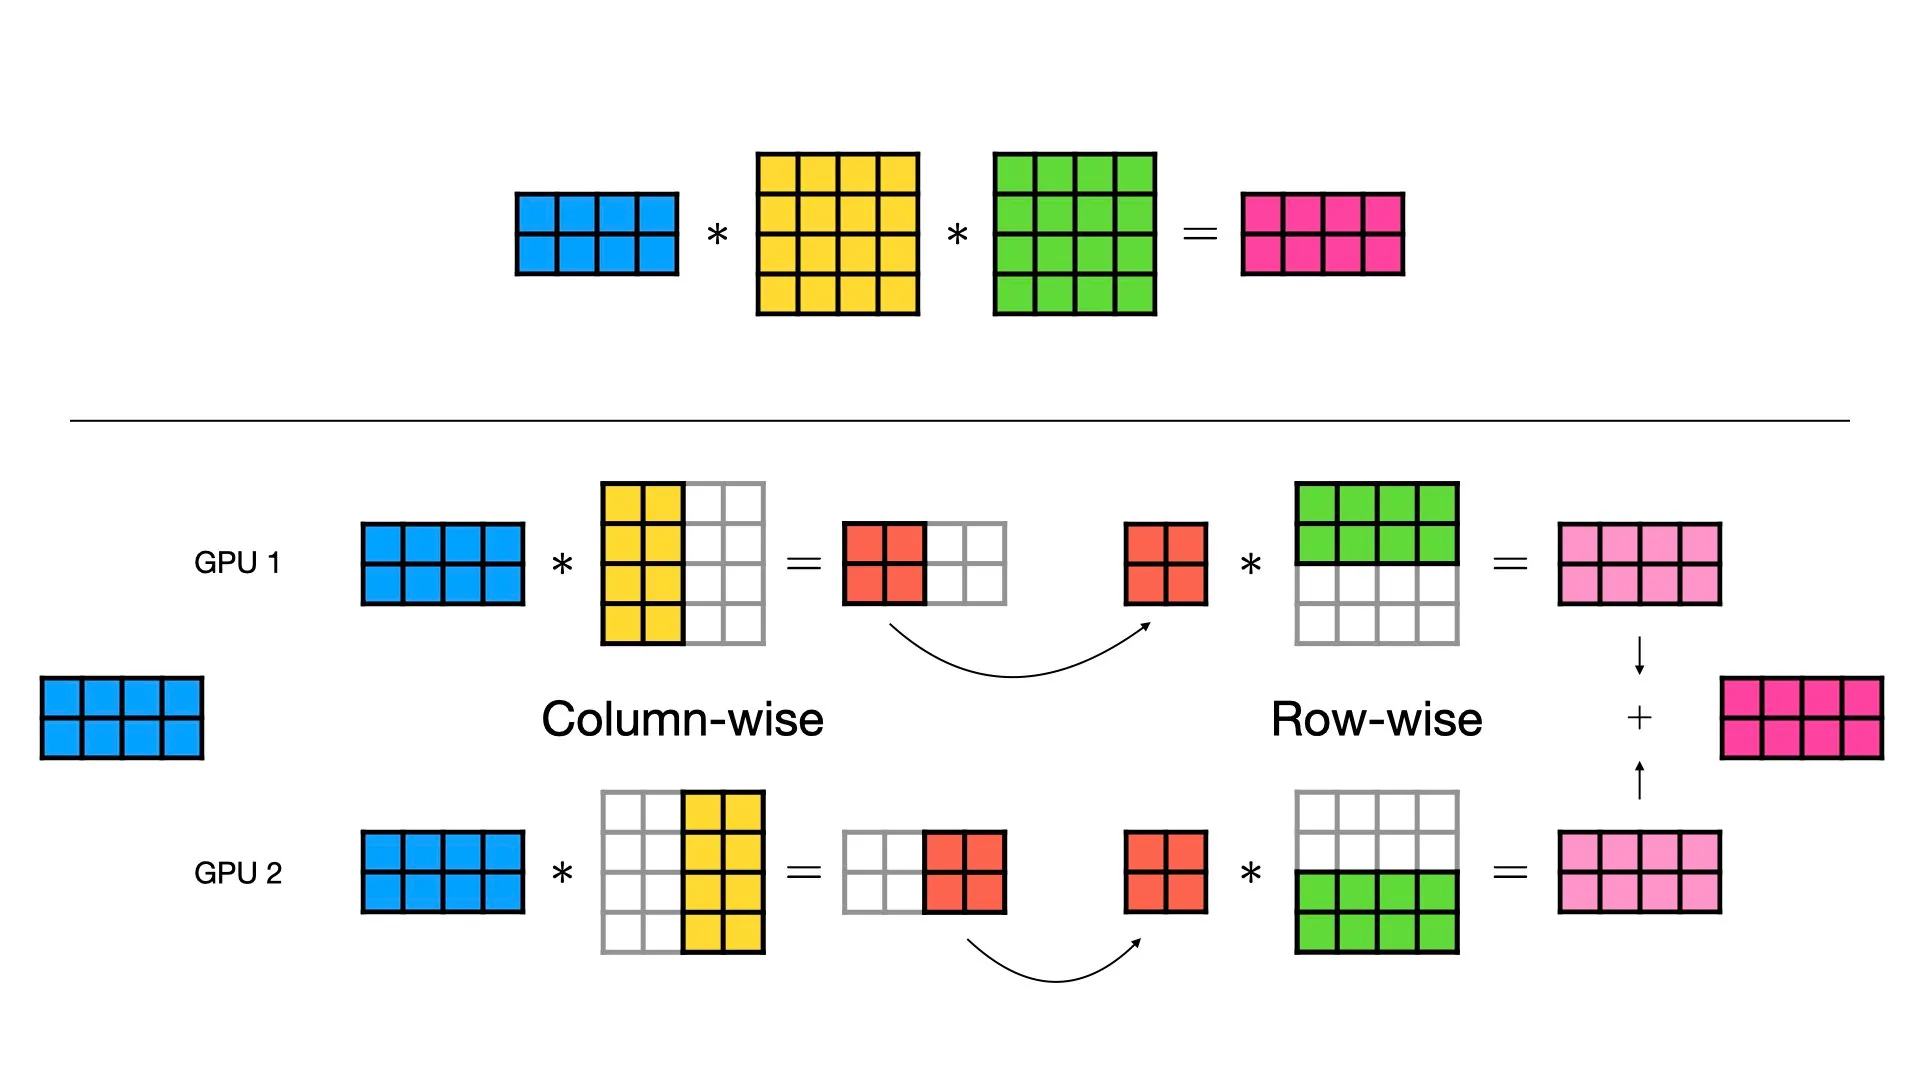
两种切法的数学基础都是分块矩阵乘法,差别在于本地结果是输出分片还是部分和,以及下一步能否直接使用3。对于可均匀切分的矩阵,每个 rank 持有约 的权重,并承担约 的 GEMM 计算量。
Transformer 的工程实践
rank 间通信会占用互联带宽并引入同步等待,因此应尽量推迟到确有必要的位置。判断这个位置,只需沿计算过程向后看:每个 rank 能只用本地数据完成的计算都先在本地进行,直到必须依赖其他 ranks 的数据或结果时再通信。推迟通信的手段通常有:调整分片,让后续计算所需的数据都位于本地、复制共同需要的数据、利用矩阵运算的结合律与分配律,让本地结果直接进入下一步计算。
具体到 Attention,切分权重时会让 、、 的分片边界与完整 head 对齐,而不是任意切开输出列。这样可以在本地计算出每组 heads 完整的 Attention,并将 TP AllReduce 推迟到 output projection 之后。否则,如果一个 head 被分散到多个 ranks,本地 就只能得到部分和,必须在 softmax 前完成归并。
设模型共有 个 Q heads 和 个 KV heads,每个 head 的宽度(head_dim)为 。heads 可均匀切分时,每个 rank 持有的 heads 数量为:
每个 rank 持有的权重分片维度为:
令 表示 TP group 内的 rank 序号。rank 对应的 Q head 编号区间为 ,KV head 编号区间为 。对应的权重分片记为 。
本地 // projections 为:
若 Q head 与其依赖的 KV head 位于同一个 rank,、softmax 和 都能在本地完成。合并本地 head 维后,计算投影后的 hidden states 部分和:
各 对应相同的序列位置和 hidden 维度,但只包含本地 heads 的计算结果,因此需要通过 AllReduce 求和得到完整的 ,再进行残差连接。
vLLM 的 QKVParallelLinear 就是沿 head dimension 并行,并根据 TP degree 计算每个 rank 的 Q/KV heads。
但这种 head 分配假设 KV heads 可均匀、完整切分(通常是人工对齐),但实际并不总是如此。TP 超过 KV heads 后会复制 KV heads,从而让每个 rank 至少持有一个完整 head,并在本地完成 Attention。代价是 、 权重与 KV Cache 出现重复,不再随 TP 等比例缩小。可以用 DPA、CP 降低这部分重复,见下文。也可以专门开发消除冗余的功能,但可能涉及复杂写入、恢复的过程。
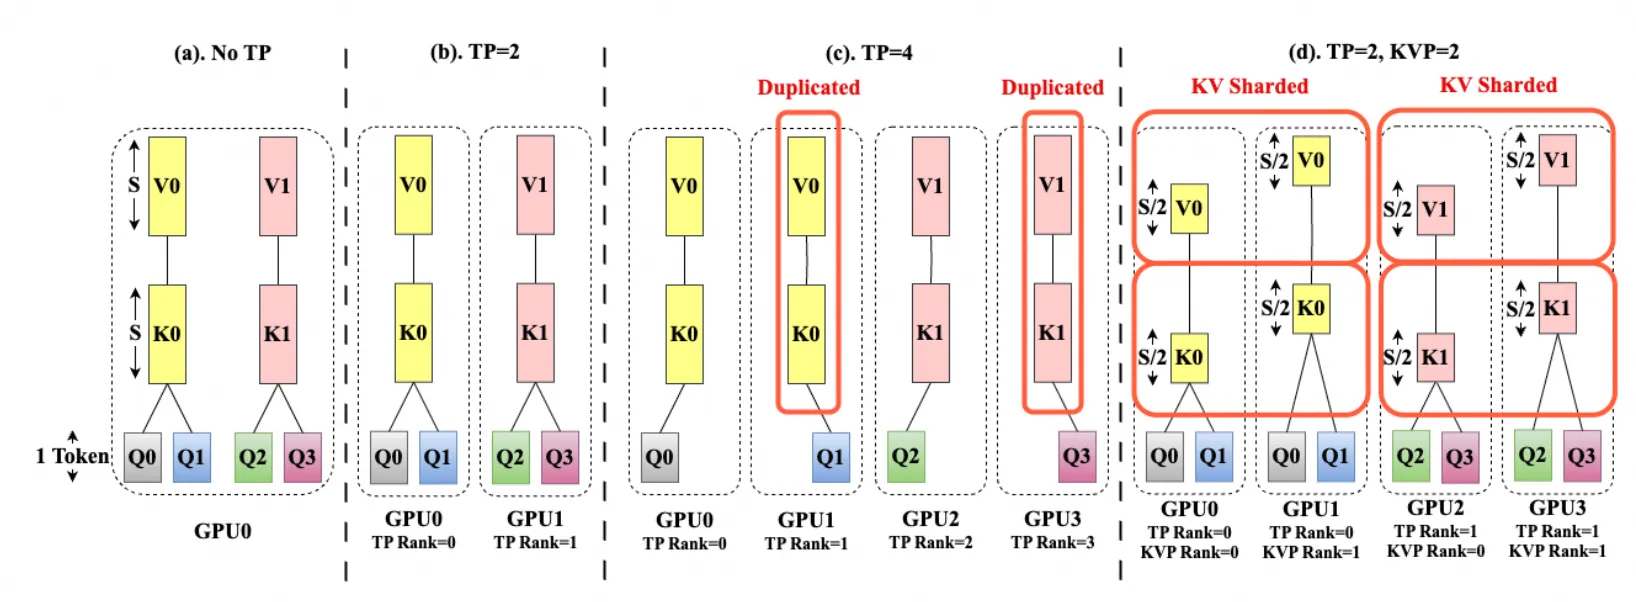
至于 SwiGLU FFN,gate/up projection 沿输出维切分,SiLU 与逐元素乘法在本地完成,只有 down projection 沿输入维切分,需要另一次 AllReduce。因此一个 Transformer block 的 forward 通常有两次 AllReduce,分别位于 Attention output projection 和 FFN down projection 之后。
代价:高频 AllReduce 限制扩展规模
在上述 TP 路径中,Attention output projection 和 FFN down projection 都已将本地结果映射回 hidden size 。部分和的 shape 均为 ,包含 个元素,只与总 token 数 和 有关,与 Q/KV heads 数量无关。Ring AllReduce 中,单个 rank 发送的元素数量近似为:
以 Qwen3-235B-A22B4 为例,、94 个 decoder blocks、64 个 Q heads、4 个 KV heads、BF16。假设 ,Decode batch 、:
BF16 时,Ring AllReduce 下,每个 rank 发送约 MiB。每个 decoder block 有两次 AllReduce,94 个 blocks 的累计通信量为:
以 H200 的 900 GB/s 双向 NVLink 带宽为上限,单次 Ring AllReduce 的 Speed of Light 为:
不过在公开的 8×H200 NCCL 测试5中,单次 512 KiB AllReduce 约为 μs。
适用场景
TP 的核心收益是降低单卡权重和单卡计算量。
Prefill 更适合开启 TP,因为该阶段普遍 compute-bound,计算强度跟序列长度成正比,TP 分摊计算的效果明显。尽管 Prefill 的通信绝对量(取决于总 token 数,而非请求数)通常更大,但其计算强度更高,通信占比反而较低,所以总延迟通常降低。
Decode 通常 memory-bound,需要靠增大 batch 提高计算强度,单纯减少计算量带来的延迟收益有限。权重分片仍能减少单 rank 的访存,但 AllReduce 增加了通信延迟,总延迟未必下降。
随着 TP 增大,本地计算与权重访存进一步被分摊,但每次 AllReduce 归并的 hidden state 大小却不随 TP 缩小。只有当本地执行时间的下降能够覆盖新增通信延迟,继续增大 TP 才有收益。
另外,Tree 与 NVLS 等互联通信层面的优化可以降低延迟,但不会改变每个 decoder block 需要两次 AllReduce 的频次,因此 TP 仍强依赖高速互联。
推理引擎参数
| 引擎 | 参数 |
|---|---|
| vLLM | --tensor-parallel-size |
| SGLang | --tp |
| RTP-LLM | --tp_size(TP_SIZE 环境变量);--ffn_sp_size(FFN_SP_SIZE 环境变量)使 FFN TP degree 变为 TP_SIZE/FFN_SP_SIZE |
| TensorRT-LLM | tensor_parallel_size 参数或 --tensor_parallel_size option |
PP:切分模型层
Pipeline Parallelism 沿模型深度切分,将连续 layers 分给不同 stages,均匀切分时每个 stage 持有约 的模型层。各层的权重和 KV Cache 留在所属 stage,hidden states 随计算推进传给下一 stage。PP 降低单卡权重占用,但不减少单请求的总计算量。
每个 stage 完成本地模型层后,输出已是下一 stage 的输入,无需在 PP stages 之间求和归并。通信只发生在 stage 边界,频率低于每层多次通信的 TP。因此工程上常把 TP group 放在高速节点内互联,把 PP boundary 放到节点间网络。vLLM 的扩展指南6和 TensorRT-LLM 的 sharding 指南7都给出了这类部署路径。
PP 在训练和推理的差异
训练中的 PP 通常把一个 batch 切成多个 microbatch,forward/backward 的依赖会带来等待和气泡。在线推理只有 forward,continuous batching 可以持续注入新的请求批次。Orca8 采用 iteration-level scheduling,让不同 stages 同时处理不同请求批次。请求充足时,传统 pipeline 气泡不再是主要问题。
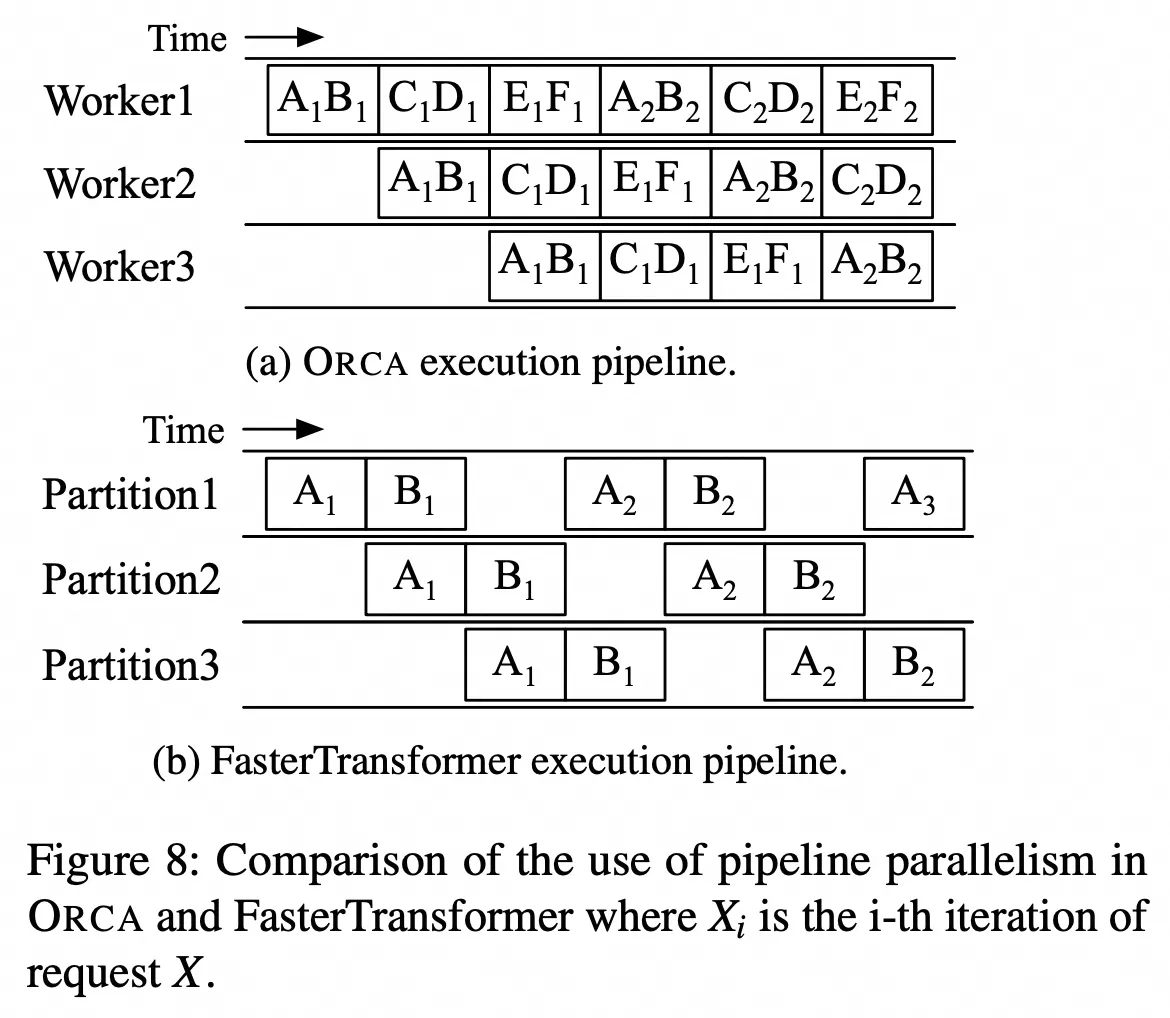
Continuous batching 不能保证每轮计算耗时相同。Prefill 长度、Prefill/Decode 比例的变化都会造成波动。Sarathi9 用 chunked prefill 和 decode-maximal batching 均衡每轮处理的 tokens。Sarathi-Serve10进一步按 TBT SLO 设置 token budget,缩小 pipeline 气泡。
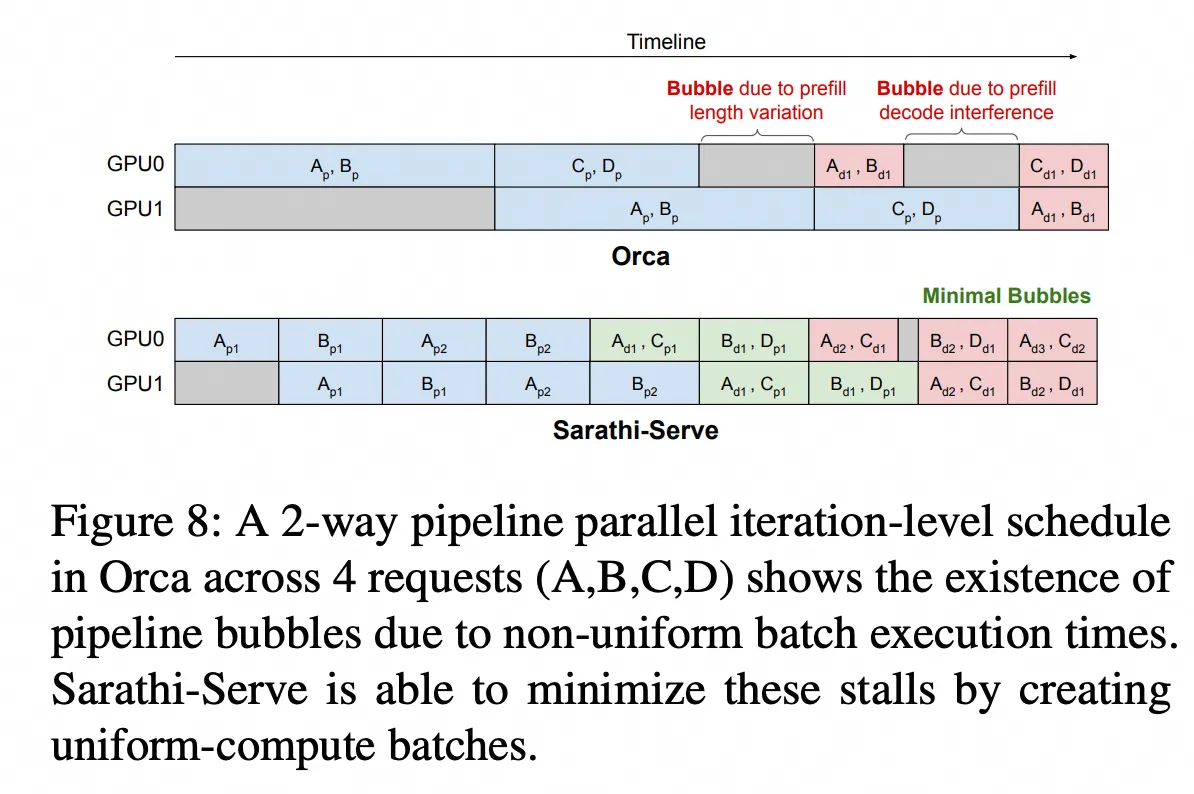
因此,推理中的 PP 气泡主要来自请求不足、stage 切分不均和每轮计算耗时波动,而不是训练中 microbatches 带来的启动和排空等待。
推理引擎参数
| 引擎 | 参数 |
|---|---|
| vLLM | --pipeline-parallel-size,仅支持实现 SupportsPP 的模型 |
| SGLang | --pp-size |
| RTP-LLM | 不支持 |
| TensorRT-LLM | pipeline_parallel_size 参数或 --pipeline_parallel_size option |
DP:完整副本与 DP Attention
训练和推理的 DP 同样有差异。标准 DP 只是完整副本的部署封装,对于推理优化有限;DP Attention 则让 Attention 权重副本分别处理不同请求。
Replica DP:等价于独立部署
Replica DP 复制完整模型,并为每个副本分配独立的 KV Cache pool。各副本独立处理不同请求,因此单请求延迟、单副本显存和每 GPU 计算量都不变。集群吞吐的增加来自新增 GPU,与启动多个独立实例再接入 router 没有差异。推理没有训练 DP 中跨副本归并梯度的步骤。
vLLM11 对非 MoE 模型建议直接启动独立 instances。SGLang 的 standard DP 同样是完整副本,生产环境建议由 SMG 路由独立 workers12。
DP Attention:让 Attention 权重副本服务不同请求
当 TP degree 超过 KV heads 数量,、 无法继续切分(head 必须是完整的)。为了让 Attention 保持本地计算,推理框架会把同一个 KV head 的权重复制到多个 ranks。这些 ranks 会计算出相同的 和 ,并写入各自的本地 KV Cache,造成重复。
以 32 个 Q heads、4 个 KV heads 的 GQA 为例。TP=4 时,每个 rank 分到 8 个 Q heads 和 1 个 KV head,、 及 KV Cache 合计仍是一份。TP 增加到 8 后,每个 rank 分到 4 个 Q heads,但仍需要至少 1 个 KV head,因此同一个 、 会出现在 2 个 ranks 上,KV Cache 随之被复制。
vLLM、SGLang 和 RTP-LLM 都会在 TP > KV heads 时复制 KV head 权重;TensorRT-LLM13 和 Helix RFC #3401814给出了相同的 GQA 示例。MLA 的缓存状态由所有 Q heads 共享,因此复制问题更严重。SGLang 最初为 MLA 引入 DP Attention15也以减少 replicated KV Cache 为主要动机。
DPA 解决的是 Attention 与 FFN 所需并行度不一致的问题。 以上例,Attention TP=4 已经可以分配 4 个 KV heads,FFN 权重却仍需要 8 个 ranks 分片。DPA 不消除权重复制,而是在相同的 8 个 ranks 上建立两个 Attention TP=4 groups。两个 groups 各自持有一套 Attention 权重,分别处理不同请求。每条请求只进入一个 group,因此只生成一份 KV Cache。FFN 仍使用全部 8 个 ranks。
由于 Attention 与 FFN 使用不同的并行度,因此切换子层时需要跨 groups 重排 hidden states,KV Cache 则保留在原 Attention group。
假设每个 rank 的 KV Cache pool 最多容纳 条请求:统一使用 TP=8 只能服务 条请求;DPA=2、Attention TP=4 可以让两个 groups 各自处理 条请求,合计服务 条请求。每个 rank 使用的 KV Cache bytes 没有减少,整组 GPU 可以同时服务更多请求。
至于增加的容量能否转化为吞吐,不取决于 Prefill 还是 Decode 阶段,而是取决于请求流量与负载均衡能否让各 Attention groups 的本地 batch 保持充足且均衡(请求会先被分配到一个 group,再由各 group 的 scheduler 独立组 batch)。Prefill 往往只需少量长请求就能占满单个 group 的计算资源,而并发请求不足时,其他 groups 存在空闲。Decode 的单步计算受内存带宽限制,通常会尽量扩大 batch 以提高计算强度,因此在请求充足时更容易让各 groups 持续工作。超短输入、高并发的 Prefill 同样满足这一场景,也可能拿到 DPA 的收益。
DPA 代价:系统复杂度上升
即使各 groups 都有请求,单次 forward 处理的 batch size 也可能不同,混合 Prefill/Decode 时差异更大。共享 FFN 需要对齐各 groups 的执行进度,较快的 groups 因此会等待。维度不一致时还可能需要处理 padding。
另外,KV Cache 的物理存储仍在各 GPU 的本地显存中。一个 Attention group 不能直接使用另一个 group 的 blocks(因为对引擎来说,每个 group 都是独立的副本)。请求分配不均时,一个 group 的 KV Cache 可能已经满了,另一个 group 仍有空闲。复用 prefix 时,还要把请求分配到已有 KV 的 group。从分布式的角度看,这是容器副本里继续嵌套多个状态不一致的副本。若直接按实例汇总请求数和 KV Cache 使用率信息,会缺失 group 维度的信息。框架要么暴露更多维度并允许上层干预 group 路由,要么在实例内部完成二次路由。否则上游的负载均衡和 cache-aware routing 都可能受到很大影响。
总而言之,为了避免 group 的负载不均和维持 cache 命中率,系统都变得更加复杂。
推理引擎参数
| 引擎 | Replica DP | DP Attention |
|---|---|---|
| vLLM | --data-parallel-size | MoE 模型使用 --data-parallel-size,可选 --enable-expert-parallel,Attention 在各 DP ranks 间复制 |
| SGLang | --dp-size,每个 worker 持有完整模型和独立 KV Cache | --dp-size 与 --enable-dp-attention,DP 必须整除 TP,Attention TP 变为 TP/DP |
| RTP-LLM | --dp_size(DP_SIZE 环境变量) | MoE 下 DP_SIZE 复制 Attention,默认 EP_SIZE=TP_SIZE×DP_SIZE,FFN experts 跨全部 ranks 分片 |
| TensorRT-LLM | 无专用参数,启动独立 instances | tensor_parallel_size 与 enable_attention_dp,Attention 权重复制,FFN 保持 TP/EP |
CP:沿序列切分计算与状态
CP 沿序列维切分 /,分摊 KV Cache 存储与 Attention 计算。
Attention 各 heads 计算相互独立。与 TP 组合时,可以只看 TP 切分后的一组 heads,由同一 CP group 沿序列维分摊这组 heads 的计算与 KV Cache。切分序列不会改变权重矩阵的维度,因此纯 CP 不分摊权重。与 TP 组合时,权重仍由 TP 切分。
Prefill 可以沿序列维切分激活,但 Decode 每条请求的 长度为 1,无法再沿序列维切分,因此需要各 KV Cache 分片获得相同的、与本地 KV heads 对应的 。
Prefill CP:固定 ,循环交换 / blocks
以连续分片为例,CP 沿 将输入均分成 个 blocks:
各 ranks 使用相同的权重矩阵(与 TP 组合时则使用同一份 TP 权重分片),计算本地 //:
本地 仍需访问完整的 /。最直接的方式是 AllGather 所有 / blocks,再计算本地 Attention。但这样每个 rank 都要暂存一份完整的 /,增加激活峰值。能否让 留在本地,逐块接收 /,算完就释放呢?
Ring Attention16 将 FlashAttention-21 固定 tile、依次处理 / tile 的方式扩展到设备之间。第 个 rank 固定本地 ,让 / blocks 沿 ring 流动,并用 online softmax 在本地累积结果。算法只收发 和 ,不依赖其他 rank 上的 Attention 计算结果。
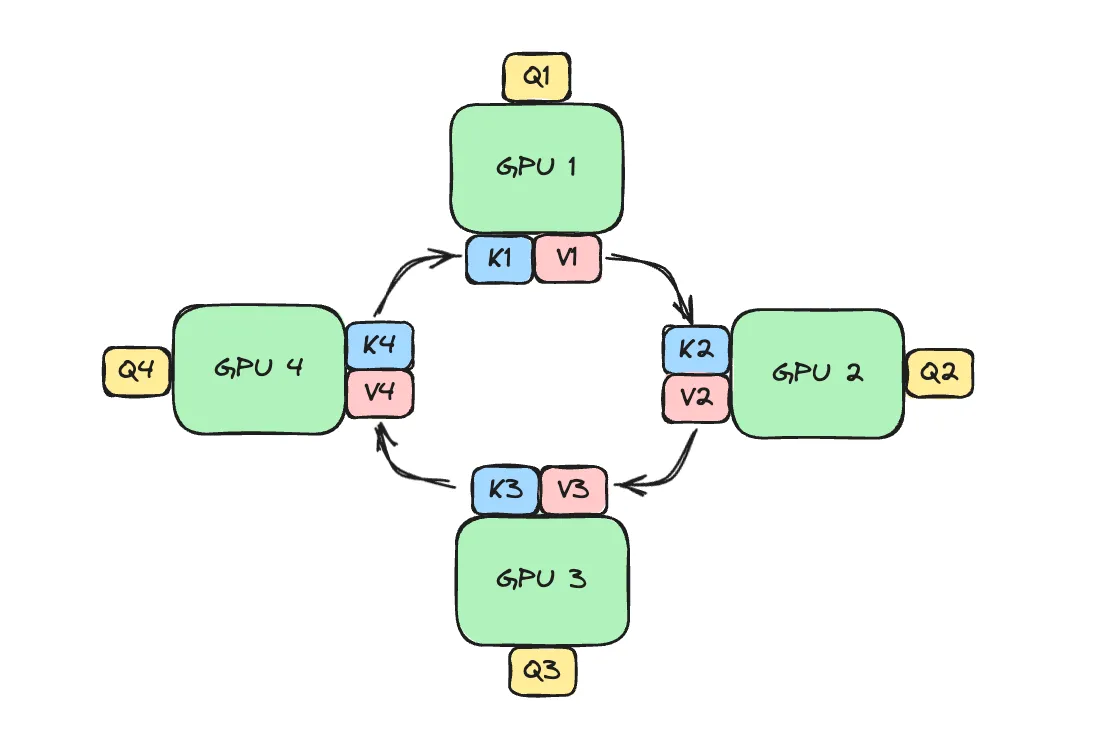
经过 次通信,rank 已处理全部 / blocks,得到本地序列位置的完整 Attention 结果:
与 TP 组合时,序列分片的 heads 又分布在多个 TP ranks 上,各 rank 计算 ,再通过 TP group 内的 AllReduce 求和,得到 。残差连接、RMSNorm 和 FFN 都可以逐位置处理。判断是否需要通信,要看后续计算依赖哪个维度:例如 RMSNorm 需要完整的 维结果,因此 TP 沿 head/hidden 维切分产生的部分和必须先归并。而 CP 只划分序列位置,保留每个位置完整的 维结果,后续计算可以直接处理本地序列,无需拼接。
暂不考虑 causal mask。每个 rank 持有长度为 的序列块,因此单个 head 的 。计入 batch 与 TP 并行后,单 rank 的 KV Cache 存储量与 Attention 总计算量分别为:
因此,Prefill CP 不只分摊 KV Cache 存储,也把单个 rank 的 Attention 计算量近似降到 。这一点与 TP 相似,只是 TP 切 hidden/head 维,CP 切序列维。
Ring 按 block 计算和传输:计算当前 / block 时,同时向下一 rank 发送该 block,并从上一 rank 接收下一块,随后继续计算16。这样无需暂存完整的 /,也能重叠计算与通信。每次发送的 block 与本地 KV Cache 分片大小相同,单 rank 的总发送量为:
增大 CP 会缩小单次传输的 block,但也会增加 Ring 的通信次数。
Decode CP:固定 KV Cache 分片,归并局部结果
Decode 每条请求当前 step 的 长度为 1,无法再沿序列维切分。因此,DCP 将历史 / 固定在各 ranks,让同一个 与不同 KV Cache 分片计算,再归并局部结果。KV Parallelism(KVP)也采用这一思路,对应本文的 DCP。
本地输出 与该组完整的 具有相同 shape,却只包含 对一段历史的计算结果,因此不能像 PCP 那样沿序列维拼接。各 rank 又分别使用了局部 softmax 分母,也不能直接相加。每个 rank 需保留每个 Q head 的 LSE,即局部 softmax 分母的对数,记为 ,归并时按各分母所占比例加权18:
这样,只交换局部 和 LSE 就能恢复完整序列的 Attention,无需传输历史 / 或 Attention score 矩阵。PCP 在本地逐块归并,DCP 则直接跨 ranks 归并,两者都基于 online softmax。
以 vLLM 默认的 ag_rs 路径为例19:
- AllGather ,让同一 DCP group 内的各 ranks 获得所需的全部 ,再计算局部 Attention。
- AllGather LSE,将本地 乘以上式中的归并系数。
- 对修正后的结果做 ReduceScatter。求和恢复完整 Attention,再沿 Q head 维分给各 ranks,直接进入各自的 分片。
单 rank 每个 step 的 Attention 计算量为:
上式中的 TP 表示 Attention 沿 heads 的切分 degree,CP 表示同一组 heads 的 KV Cache 分片数。对上述 ag_rs 路径,记同一 DCP group 所需的 与归并前局部 大小分别为 和 。忽略体积更小的 LSE,若 AllGather 与 ReduceScatter 均按 Ring 执行,单 rank 的发送量为:
固定 heads 的切分方式时,增大 CP 会继续降低单 rank 的 KV Cache 存储与扫描量,但 、 不变,单 rank 通信量随上式系数增加。历史序列越长,分摊的 KV Cache 读取越多,而这部分通信量不随历史长度增长。
TP、DPA 与 CP 的取舍
TP 沿 head/hidden 维切分权重与计算。假设 8 个 ranks 上,Attention 使用 TP=4 后,KV heads 已经无法继续切分,剩余的 2 倍并行度可以用 CP,也可以用 DPA,该怎么选呢?
### 用 CP,8 个 ranks 共同处理同一批请求 ###
TP=4, CP=2
TP group A: GPU 0,1,2,3 # 序列分片 0
TP group B: GPU 4,5,6,7 # 序列分片 1
CP group 0: GPU 0,4     # 同一 TP weight shard,不同序列分片
CP group 1: GPU 1,5
CP group 2: GPU 2,6
CP group 3: GPU 3,7

### 用 DPA,两个 Attention groups 独立处理不同请求 ###
TP=4, DPA=2
Attention group A: GPU 0,1,2,3 # 一组请求
Attention group B: GPU 4,5,6,7 # 另一组请求- 权重与容量:CP 把一条请求的 KV Cache 分散到全部 ranks;DPA 则把总容量拆成两个独立 pools(可能因请求分配不均产生碎片)。两种方案都不继续切分权重,都解决 KV Cache 冗余,因此理想容量相同。
- 数据搬运:CP 减少单 rank 的 KV Cache 存储,但新增 inter-rank 通信(如果 CP group 跨主机,会变成 inter-node 通信)。DPA 不需要为单条请求交换 Attention 状态,但进入共享 FFN 前后仍要通过 AllGather/ReduceScatter、All-to-All 或等价方式跨 groups 搬运 hidden states。每个 rank 还需要读取完整长度的本地 KV Cache,单 rank 峰值显存相较于 CP 更高。
- 吞吐:以同一份工作为单位,CP 的 8 个 ranks 合作完成 1 份,吞吐为 ;DPA 的两个 groups 可以同时各完成 1 份,吞吐为 。
- 开发难度:CP 的序列划分由静态拓扑决定,而 DPA 需要在多个 Attention pools 之间动态路由,需要同时考虑 group 负载、KV Cache 容量与 prefix locality,策略相对复杂。
- 单次执行时间:只看 、softmax 与 ,设 表示无法被计算隐藏的 CP 通信与同步时间。理想均分时,CP=2 的 。DPA 的单请求仍由一个 TP=4 group 完成,耗时近似 。projections 和 FFN 则需按各自的实际分片另计。
以 Qwen3-235B-A22B4 和 H200 估算 、 的量级。模型取 、、、、BF16。H200 的 HBM 带宽为 4.8 TB/s,BF16 非稀疏理论峰值约为 989 TFLOPS,NVLink 双向带宽为 900 GB/s。
PCP
本地计算与 KV Cache。 沿用前文不考虑 causal mask 的口径。KV Cache 大小与 Attention 计算量分别由前文的 、 公式给出。
取 、 和 TP=4。不开 CP 时,单 rank 的 Attention 计算量约为 TFLOPs,projections 约为 TFLOPs,合计 TFLOPs,本地 KV Cache 为 16 MiB。H200 的理论计算时间下限约为 ms。
CP=2 后,单 rank 的 Attention 计算量约为 TFLOPs,由两个 TFLOPs 的 / blocks 组成,projections 约为 TFLOPs,合计约为 TFLOPs,本地 KV Cache 降到 8 MiB。理论计算时间下限约为 ms。
跨卡通信。 使用异步 P2P 与双 buffer 时,rank 可以在计算当前 block 的同时接收下一块。同时收发 8 MiB 的理论耗时约为 μs,远低于理论计算时间。
DCP
本地计算与 KV Cache。 沿用前文的 与 公式。
取 、 和 TP=4。不开 CP 时,单 rank 的 Attention 计算量约为 GFLOPs,本地 KV Cache 为 1 GiB。按 H200 的理论峰值计算,Attention 计算时间下限约为 μs,KV Cache 扫描时间下限约为 μs,因此 Decode Attention 受 HBM 带宽限制。
CP=2 后,单 rank 的 Attention 计算量约为 GFLOPs,本地 KV Cache 降到 512 MiB,两项时间下限分别降到 μs 和 μs。
跨卡通信。 DCP 固定本地 /,无需像 PCP 交换 / blocks。按前文 ag_rs 路径的 公式,忽略 LSE,CP=2 时单 rank 发送量为 256 KiB,在 900 GB/s 双向带宽下,同时收发的时间下界约为 μs。这是 Speed of Light 估算,实际还包含 collective 启动与同步开销。作为参考,8×H200 NCCL 测试5中,256 KiB AllReduce 约为 μs。
总结一下,模型权重放不下,先使用 TP、PP;Cache 放不下,可以用 CP。CP 不一定能带来加速,尤其是通信跨节点时,通信延迟可能无法忽视。最好实测。只有请求充足、吞吐优先时,才考虑 DPA。
序列布局:Contiguous、Zigzag 与 Striped
Causal Attention 中, 的位置越靠后,参与计算的 / 越长。为了避免负载不均,CP 还要为各位置选择合适的布局20。
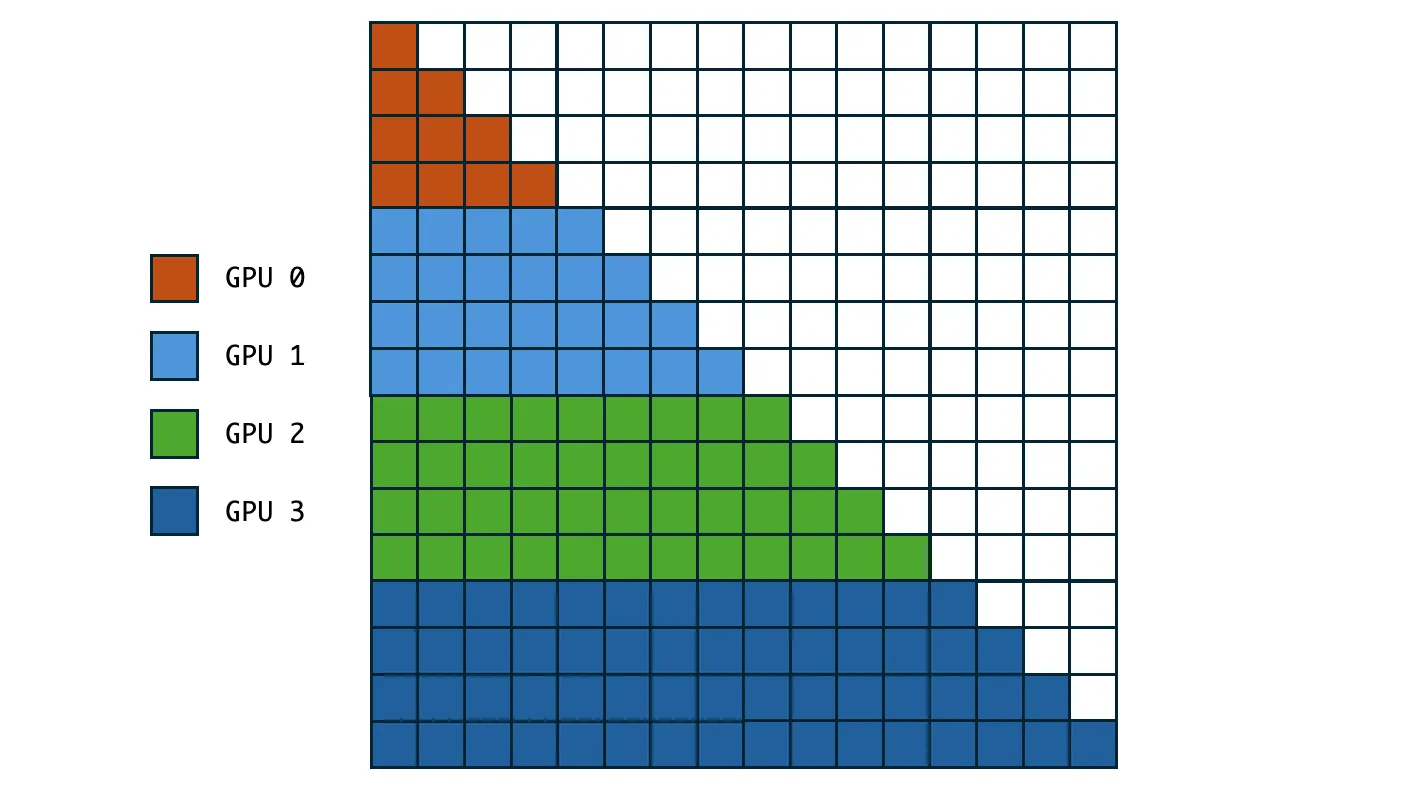
Contiguous
Contiguous layout 最直观:rank 持有 ,其中 。位置从 0 开始编号时,位置 的 需要处理前 个 / 位置,因此 rank 的 Attention 计算量近似为:
Contiguous 的区间连续,位置、mask 和 KV Cache 映射最简单,也最容易复用现有 Attention kernel。但 Causal Attention 的计算量集中在后半段,负载非常不均,整体时间取决于最慢的 rank。
Zigzag
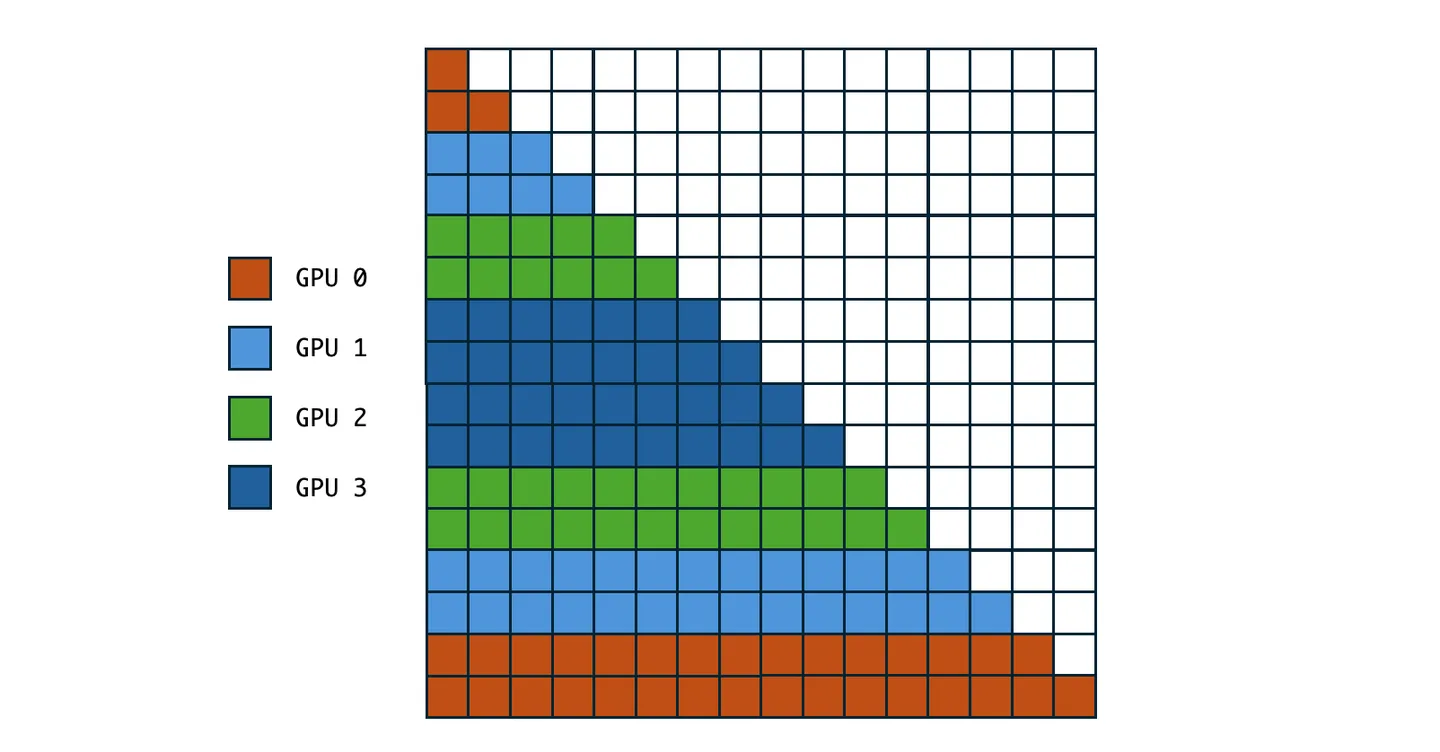
Zigzag 先把序列分成 个连续 blocks,再让 rank 同时持有 early block 与 late block 。例如 ,四个 ranks 分别持有:
rank 0: [0..3]   + [28..31]
rank 1: [4..7]   + [24..27]
rank 2: [8..11]  + [20..23]
rank 3: [12..15] + [16..19]
四个 ranks 需要处理的 / 位置总数均为 132。Zigzag 用一个早期块配一个后期块,在均衡 Causal Attention 计算量的同时,仍为每个 rank 保留两个连续区间,便于复用现有 Attention kernel。注意 Zigzag 的分片依赖静态的序列总长度,因此主要用于 Prefill。写回 KV Cache 时按原始序列顺序重排即可。
Striped
序列顺序决定 Attention 结果,但不必等于 tensor 的物理排列。Striped 不改变 token 在完整序列中的位置,只改变存储它的 rank。位置 对应的 rank 为:
因此,rank 持有的位置为 。
该映射不依赖最终序列长度,既能均匀分配早期和后期的 ,也能让新增 token 直接写入对应 rank,适合持续增长的分片 KV Cache。这些 token 在单卡上仍然紧凑存储,因此不会破坏物理访存连续性。
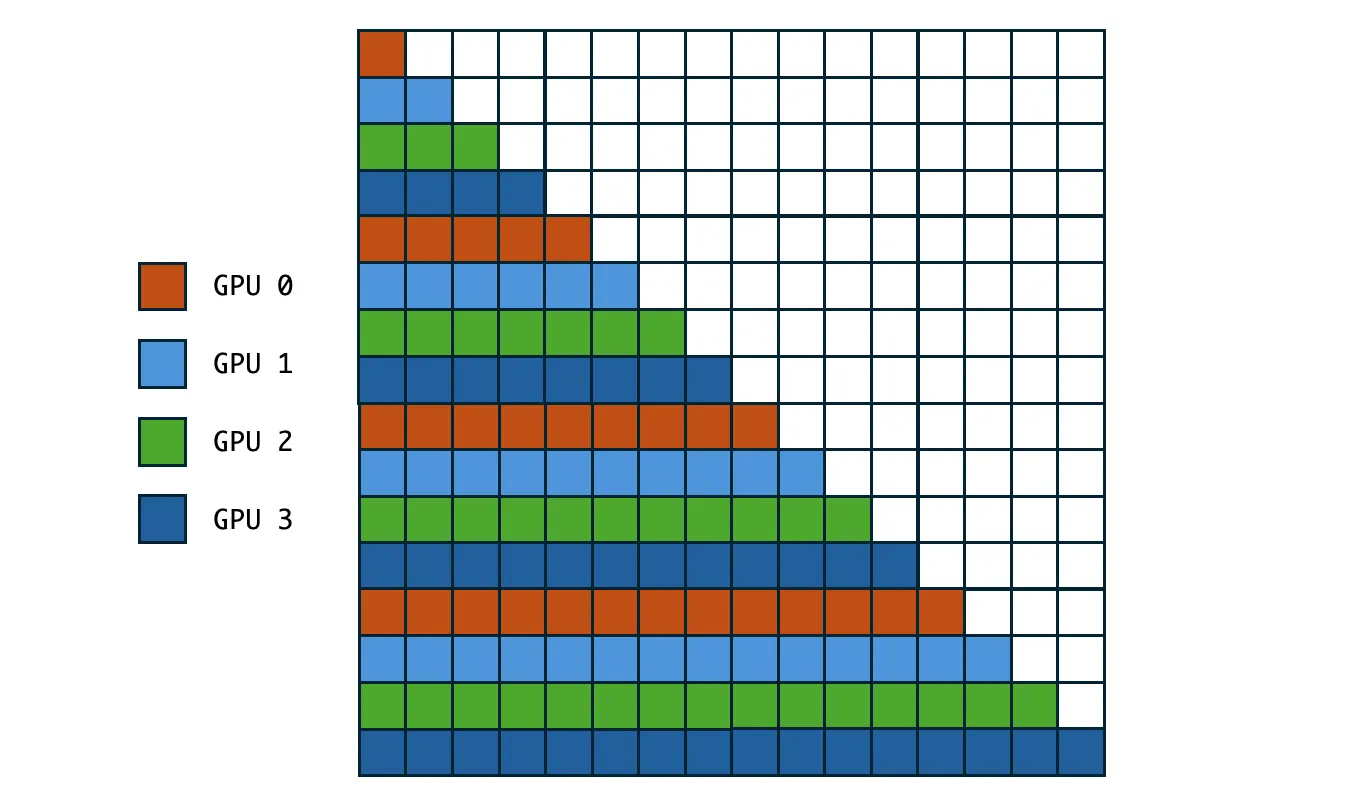
Striped Attention21 在 embedding 前按 将属于同一 rank 的 tokens 排在一起再分给各设备。后续 layers 保持该布局,无需恢复原始顺序。
以 为例。每个 rank 上的 tokens 都会紧凑存储, 保持不动,/ blocks 沿 ranks 交换:
初始:
rank 0: Q[0,2,4,6] × K/V[0,2,4,6]
rank 1: Q[1,3,5,7] × K/V[1,3,5,7]

交换 K/V 后:
rank 0: Q[0,2,4,6] × K/V[1,3,5,7]
rank 1: Q[1,3,5,7] × K/V[0,2,4,6]
Attention 不依赖 // 在 tensor 中的排列顺序,kernel 只需按 token 在原始序列中的位置生成 causal mask。例如 rank 0 处理第二个 / block 时, 只能看到 , 可以看到 。各 rank 用 online softmax 归并,无需原始序列顺序也能恢复 Attention 的正确语义。
Attention 之外的逐 token 计算可以继续沿用 Striped 顺序,因为这些操作本就不依赖序列的全局位置。Striped 也不改变 / block 大小和 Ring 的通信次数,因此不会增加通信复杂度。额外成本主要来自 Attention kernel 与 KV Cache 管理对 Striped 布局的适配。Striped 与 Local Attention 组合时,需要根据 token 在原始序列中的位置判断各自的 Attention 范围,例如 sliding window 的窗口边界。
总结一下,Contiguous 的实现和数据布局最简单,但面对 Causal Attention 会非常不均衡。Zigzag 与 Striped 都能均衡 Attention 计算,也都需要适配 Attention kernel、KV Cache 管理和 Local Attention 的边界。Striped 进一步取消了对固定序列长度的依赖,理论上同时适用于 Prefill 和 Decode,是 Zigzag 的更佳替代。不过在部分社区实现的 benchmark22 中,Striped 的性能低于 Zigzag,说明实际结果仍受具体实现影响,仅供参考。
推理引擎参数
| 引擎 | Prefill CP | Decode CP |
|---|---|---|
| vLLM | --prefill-context-parallel-size 扩张 ranks 并切分 Prefill 计算,不增加持久 KV Cache 的分片数 | --decode-context-parallel-size 不扩张 ranks。PCP 关闭时复用 TP ranks,与 PCP 同开时可覆盖 PCP 或 TP×PCP ranks。GQA 仅使用 TP 超过 KV heads 后的冗余并行度 |
| SGLang | --attn-cp-size 在 TP ranks 内建立 CP group,--enable-prefill-cp 与 --cp-strategy 选择序列布局 | --dcp-size 复用 TP ranks,--dcp-comm-backend 选择 AG+RS 或 All-to-All |
| RTP-LLM | --cp_rotate_method(CP_ROTATE_METHOD 环境变量)复用 TP ranks,支持 AllGather/All-to-All,--prefill_cp_kv_cache_sharded 单独控制 KV pool 分片 | 无通用 Decode CP |
| TensorRT-LLM | 无通用 Ring PCP | Decode-only Helix 使用 context_parallel_size 与 cp_config.cp_type=HELIX,沿序列切分 KV Cache 并使用 All-to-All |
vLLM 还有些额外的优化选项,思路源于 Helix,见下文:
--dcp-comm-backend a2a:一起交换局部 与 LSE。默认使用ag_rs,模型可覆盖默认值。--dcp-q-replicate:在 DCP group 内复制生成 所需的权重,各 rank 本地计算 ,省去 Q AllGather。目前适用于已支持的 MLA 模型,DeepSeek MLA 仅在 PCP 关闭时启用此优化。
EP:切分专家
TP 将单个 FFN 的权重矩阵切给多个 ranks。MoE 的 experts 相互独立,因此还可以采用 EP:将完整 experts 分给不同 ranks,各 rank 保留并计算自己的 experts。
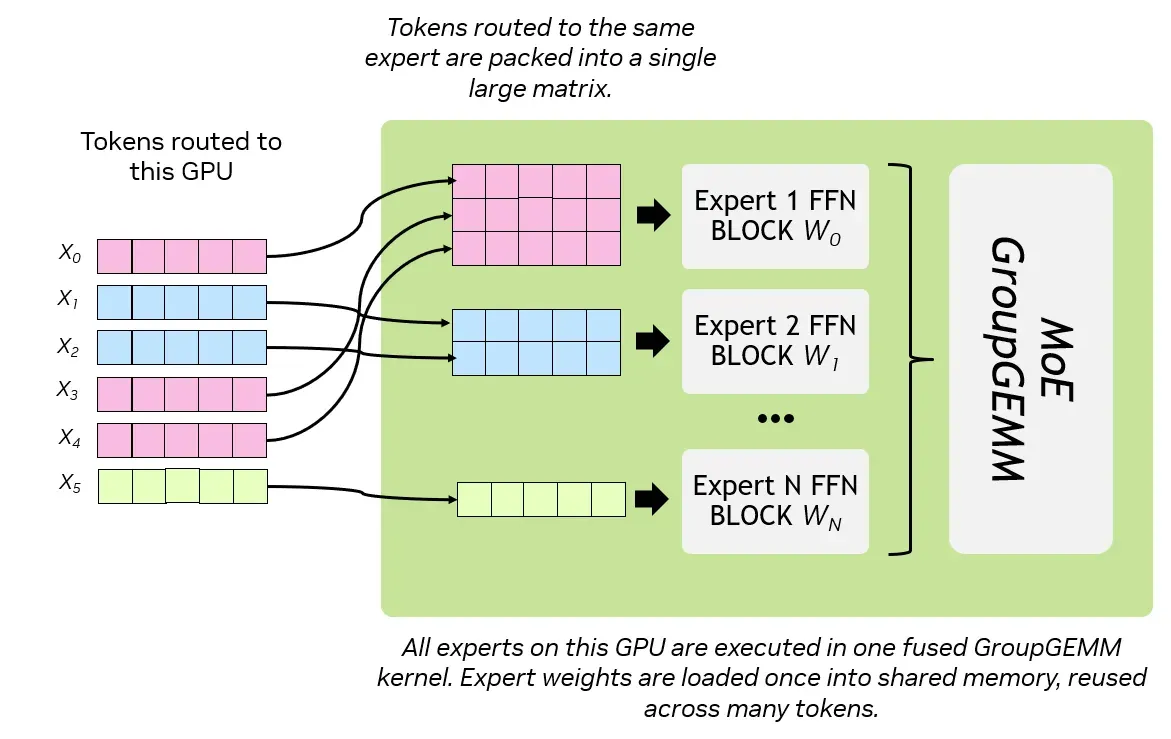
以 Qwen3-235B-A22B4 的 128 个 experts 为例。使用 TP=8 时,每个 rank 持有所有 experts 的 1/8 矩阵分片,每个被选中的 expert 都由 8 个 ranks 共同计算。改用 EP=8 后,变为每个 rank 均匀持有 16 个完整 experts。这意味着 MoE 激活部分 experts 时,也只有部分 rank 需要参与计算。请求充足、各 expert 负载均匀时,每个 rank 只承担约 1/8 的 expert 计算量。另外发往同一 expert 的 hidden states 还可以组成更大的输入矩阵,提高 GEMM 的计算强度。
EP 在 experts 之间分摊计算。如果单个 expert 仍需多卡存储或计算,可以在 expert 内继续使用 TP,形成 MoE-TP × EP。
通信:All-to-All
标准 All-to-All 路径中,各 rank 起初持有不同的 hidden states 分片。router 权重在 EP ranks 上复制,各 rank 为本地 hidden states 选择 top-k experts,并计算合并系数。expert 权重留在所属 rank,随路由传输的是 hidden states。
dispatch 将 hidden states 发往 experts 所在的 ranks,目标 ranks 用对应的本地 experts 计算,combine 再将 expert 输出送回原 ranks。原 rank 按路由系数归并结果,得到与原输入分片对应的输出。由于各 rank 都可能向多个 ranks 发送数据,也可能从多个 ranks 接收数据,dispatch 和 combine 分别构成一次 All-to-All。
对单个 hidden state ,常见的 top-k softmax router 可以写成:
记当前 EP group 有 个 hidden states,每个 rank 初始持有 个。每个 hidden state 大小为 bytes,router 为其选择 个 experts,dispatch 向每个 expert 各发送一份。假设 experts 与路由均匀,目标 expert 位于其他 rank 的概率为 。dispatch 与 combine 的通信量相等,因此单 rank 发送的远端数据量约为:
标准路径中,expert 计算要等 dispatch 结果完整就绪,combine 也要等最慢的 expert 计算完成。同一批 hidden states 只能按 dispatch 通信 → expert 计算 → combine 通信 执行。部分实现会把每个 rank 当前持有的 hidden states 再拆成几批,让不同批次交错执行这三个阶段,隐藏部分 All-to-All 延迟。代价是每批发往 expert 的 hidden states 更少,GEMM 变小,计算强度也随之下降。
DeepGEMM 的 MegaMoE23进一步将 dispatch → expert 计算 → combine 融合到一个分布式 kernel,在 kernel 内重叠 NVLink 通信与 Tensor Core 计算,减少阶段之间的等待。
与 Attention 并行的衔接
为了避免重复发送,同一份 hidden states 应只由一个 rank 发出,但标准 Attention TP 并不满足这个条件:output projection 和 AllReduce 后,组内各 ranks 得到相同的 ,经过残差连接和 RMSNorm 后结果仍然相同。如果直接 dispatch,同一份数据会被重复发送和计算。
一种实现是保留这些完整副本。每个 rank 都用完整 hidden states 副本选择 top-k experts 并计算合并系数,再筛出其中被路由到本地 experts 的 hidden states,执行对应的 expert 计算。最后通过 AllReduce 归并各 rank 的 expert 输出,恢复完整结果。这条路径无需 dispatch。
另一种实现从 Attention 输出入手,让各 rank 直接得到不同的序列分片:将 output projection 后的 AllReduce 改为沿序列维的 ReduceScatter,在归并 的同时分片 ,每个分片的 shape 为 。残差连接可以从 Attention 输入中取出对应序列分片,RMSNorm 只沿 维计算,因此都可以在本地完成。随后进入前述 All-to-All 路径,combine 将结果送回原来的序列分片。若下一层 Attention 仍使用标准 TP,则需要在 QKV projection 前通过 AllGather 恢复完整 hidden states。
DPA 与 CP 都会让 hidden states 分布在不同的 Attention groups。只要组内没有 TP AllReduce 产生的副本,就可以直接进入 All-to-All,否则也要先通过 ReduceScatter 重新分片。
负载均衡:EPLB 调整分布与增加副本
TP、CP 按拓扑固定切分同一次计算,EP、DPA 则把动态产生的独立工作分配给不同 ranks。 后两者更偏向扩展总体容量与吞吐,实际收益也更依赖工作量是否充足和负载是否均匀。
EP 可以静态均分 experts,却无法保证路由负载均匀,执行时间由计算或通信耗时最大的 rank 决定。tokens 较少时,每个 expert 分到的 tokens 更少,负载更容易失衡。继续增大 EP 虽然能减少单卡上的 expert 权重存储,却可能让 All-to-All 延迟和小 GEMM 成为瓶颈。
EPLB24根据负载重新分配 experts,并为热点 experts 增加副本。router 仍然选择原来的 top-k experts,EPLB 调整的是它们在哪些 ranks 上执行,而非改变模型的选择结果。
迁移与复制分别处理两种负载不均:
- 多个热点 experts 集中在同一 rank:迁移其中的 experts,分散到其他 ranks。不增加副本,只改变工作量在 GPUs 之间的分布。
- 单个 expert 的负载过高:迁移只会转移热点,需要复制该 expert,让不同输入由不同副本处理,才能跨 ranks 分摊它的工作量。
为了决定副本数量和位置,需要先估计各 expert 的负载。vLLM 的 EPLB25收集 forward 中各 expert 处理的输入数量,用滑动窗口汇总,周期性更新分配方案。
DeepSeek 的 EPLB 算法将这个过程分成两步:
- 决定副本数量。在给定的副本预算内,每次为“负载 ÷ 当前副本数”最大的 expert 增加一个副本,再重新比较,直到预算用完。
- 决定副本位置。按各副本的预计负载从高到低,将它们依次分给仍有 expert 槽位且当前预计负载最低的 GPU,每放入一个副本就更新该 GPU 的负载。
例如 4 个 ranks 分别持有 E0–E3,估计路由到它们的 hidden states 数量为 120、40、20、20。给定 4 个额外副本的预算,第一步会为 E0 增加 3 个副本,为 E1 增加 1 个副本。第二步再将它们分配到各 ranks,按输入在同一 expert 的副本间均匀分配估算:
| Rank | 调整前 | 调整后 |
|---|---|---|
| 0 | E0:120 | E0:30 + E1:20 = 50 |
| 1 | E1:40 | E0:30 + E1:20 = 50 |
| 2 | E2:20 | E0:30 + E2:20 = 50 |
| 3 | E3:20 | E0:30 + E3:20 = 50 |
总计算量不变,最忙 rank 的工作量从 120 降到 50,代价是存储的 expert 副本总数从 4 增到 8。实际执行 MoE 时,每条路由只选择目标 expert 的一个副本,合并系数保持不变,因此多个副本分担的是不同输入,不会重复计算。
跨节点时,还要兼顾通信。采用 group-limited routing 的模型会将 experts 分组,每个输入只从选中的少数分组中选择 top-k experts。EPLB 可以先把这些路由分组分配到节点,再在节点内复制、分配 experts,尽量让同一分组留在同一节点。否则,计算负载虽然更均匀,一次路由却可能访问更多节点,增加跨节点传输。
方案确定后,框架迁移权重并更新 expert 映射。接下来每次 forward,router 先选择逻辑 expert,再从它的副本中选择执行位置。一种低开销做法是按当前 forward 中的输入编号计算 hash,再对副本数取模,查表选择目标副本,vLLM 的 EPLB 映射采用了这种方式。若 Decode batch 有 64 条请求,输入编号就是 0–63。这种分流无需收集各 rank 的实时负载,但也不保证当前 batch 的负载均衡。
EPLB 根据负载周期性调整副本数量和位置。随着热点变化,调整间隔过长,副本分布可能落后于负载变化,缩短间隔则会增加权重迁移和同步开销。
增加副本虽然能分摊热点,却会占用原本可用于 KV Cache 的显存,并让单个副本收到的输入变少,降低 GEMM 的计算强度。EPLB 通过分摊热点缩短最慢 rank 的执行时间,代价是额外的权重存储与迁移。 副本数量和调整频率都要围绕这个取舍选择,而非只追求负载数字相等。
Wide EP:多个 Attention groups 共享的超大 EP group
Wide EP26就是让多个 Attention groups 共享一个更大的 EP group,配置上表现为更大的 EP degree。DPA、Wide EP 都是对 Attention 与 FFN 所需并行度不一致这个诉求的解法,只是一个从 Attention 侧解决,一个从 FFN 侧解决。
随着 EP degree 增大,experts 分布到更多 ranks,每个 rank 的 expert 权重读取量下降,承担的计算量也会减少。要维持单 rank 的计算量,EP group 接收的 hidden states 就需相应增加。单个 Attention group 的输入规模不变时,可以汇集多个 Attention groups 的 hidden states,按目标 expert 组成更大的输入矩阵,提高计算强度。各 rank 再通过 GroupGEMM 批量执行本地 expert 的 GEMM。
代价是 dispatch 和 combine 的 All-to-All 涉及更多 ranks。所以 Wide EP 适合高带宽的 scale-up 网络,因为跨越较慢的 scale-out 网络时,All-to-All 可能成为瓶颈,从而抵消权重访存降低和计算强度提升所带来的收益。
GroupGEMM 将多个 expert GEMM 放进一次 kernel 调度,减少启动开销并提高 GPU 利用率。它不改变路由结果和各 rank 的计算量,也不消除跨 ranks 的负载不均。
Elastic EP:不重启服务,如何改变并行规模
请求负载变化后,可以调整 EP group 的规模,以匹配吞吐需求、减少资源闲置。这通常需要重启服务,但重启代价高昂。为此,vLLM 的 Elastic EP27将扩缩容拆成提前准备和统一切换两个阶段,让旧配置在准备期间继续服务,随后在原进程中完成切换。
理论上,DPA、TP、CP 都可以与 Elastic EP 配合,但 vLLM 选择通过 DPA 扩缩容。因为改变 TP、CP degree 需要重新切分已有 KV Cache,TP 还涉及权重分片调整,而 DPA groups 彼此是完全处理的副本,增减 groups 时无需关注上述复杂的状态迁移。
不过,这些 Attention groups 共享同一个 MoE FFN,expert 分布和通信组仍需协调调整。若部分 ranks 已使用新配置,其余 ranks 仍在执行旧配置的 collective,就可能死锁。因此,准备工作可以与推理并行,正式切换则要等各 ranks 完成当前 step 后统一进行。
扩容:旧配置继续服务,新配置提前准备
以 EP group 从 ranks 0–1 扩容到 ranks 0–3 为例。新增的 ranks 2、3 先分配权重,再从旧 ranks 接收包括 Attention 在内的非 expert 权重。expert 权重稍后迁入。旧 ranks 的权重和 KV Cache 保持不变,继续处理原有请求。
通信组也要提前准备:保留原组 {0,1},同时创建覆盖 {0,1,2,3} 的备用组。准备任务在后台线程执行,非 expert 权重传输使用该线程的 CUDA stream,与推理分开提交,这使得准备工作与推理并行。但仍会争用 GPU 带宽,新旧通信资源暂时共存也会增加显存占用。
图中的统一切换从暂停调度开始,不等待请求排空,所有在途请求及其 KV Cache 仍保留在原 ranks 上。随后启用新通信组并销毁旧组。此时 experts 仍在旧 ranks 上,Elastic EP 复用 EPLB,在新 group 内重新分配并传输 expert 权重,完成后更新 expert 映射,使路由指向已就绪的 experts。最后还要重新捕获 CUDA Graph,避免复用旧配置下的通信操作和 buffer 引用。预热期间会保护现有 KV Cache,避免模拟输入覆盖真实请求的数据。完成后恢复调度,旧请求从暂停处继续生成,新 ranks 开始接收请求。
这段暂停类似 GC 的 Stop-the-World:参与该 EP group 的所有 workers 暂停后续推理 step,在途请求要等切换和预热完成后才能继续生成。因此,免重启仍会带来输出间隔的突增,工程上需要控制暂停时长,满足服务的延迟要求。
迁移时,旧 ranks 也不需要同时保存两套完整的 expert 权重。vLLM 逐层把新权重接收到 buffer,待传输完成后写回原槽位,再处理下一层。新旧权重只在当前迁移层短暂共存,各层复用同一个 buffer,其大小相当于单个 MoE 层的本地 expert 权重。这个 buffer 在启动时就已分配,并计入自动计算的 KV Cache 预算,不会在扩缩容时临时挤占 KV Cache。但新旧通信资源共存仍需预留显存,现有切换路径不会自动缩小 KV Cache pool,余量不足时可能 OOM。
缩容:先迁移 experts,再移除 ranks
扩容可以保留在途请求,缩容还需处理待退出 workers 上的请求。若不迁移或中止这些请求,就多了一段等待其完成的排空时间。这会延长缩容完成时间,排空期间已有请求仍在推理。
假设从 {0,1,2,3} 缩回 {0,1},ranks 2、3 的 KV Cache 不会随 expert 权重迁移。当前 vLLM 提供 VLLM_ELASTIC_EP_DRAIN_REQUESTS 环境变量,在切换前停止接收新请求,等待整个实例的已有请求结束,超时则取消此次切换。未开启时,缩容会直接中止被缩容 ranks 上未完成的请求。
随后暂停推理,但 ranks 2、3 仍需参与权重传输,把其他 ranks 所需的 experts 迁到 ranks 0、1。待权重与 expert 映射准备好,再切换到新的通信组,释放退出进程的资源。
上述缩容过程描述的是仍能传输权重的主动缩容 ranks,但发生故障时往往无法从失效 rank 读取权重。为此,SGLang 的 Elastic EP28预先保留 expert 副本。故障后,调度器屏蔽失效的 DPA ranks,执行层借助支持容错的 Mooncake EP,利用副本在存活 ranks 上重新分配 experts、更新路由并恢复推理。这样,expert 权重的恢复就不再依赖故障 rank。
推理引擎参数
| 引擎 | 参数与 TP + EP 行为 |
|---|---|
| vLLM | --enable-expert-parallel 与 --all2all-backend,EP group 覆盖 TP×DP 或 TP×PCP ranks,MoE-TP 变为 1,每 rank 持有部分完整 experts |
| SGLang | --ep-size 与 --moe-dp-size 将 TP group 分为 MoE-TP × EP × MoE-DP,设置 --moe-a2a-backend 时将 EP 调整为 TP |
| RTP-LLM | --ep_size(EP_SIZE 环境变量)只接受 1 或 TP_SIZE×DP_SIZE。1 表示纯 TP,默认值 0 自动设为 TP_SIZE×DP_SIZE |
| TensorRT-LLM | moe_tensor_parallel_size、moe_expert_parallel_size 参数,两者乘积等于 tensor_parallel_size |
综合分析:Helix 如何衔接不同并行策略
长序列 Decode 中,每个 step 都要读取历史 KV Cache 和 FFN 权重。前者随序列长度增长,后者在小 batch 下难以充分复用,两者都可能成为延迟瓶颈。Helix29 因此从整个 decoder block 出发,联合考虑各阶段如何利用全部 GPU,以及阶段之间需要传输什么。
避免 GPU 闲置
KVP 的切分思路对应本文的 DCP。Medha 采用 KVP 将 Attention 分散到更多 GPU,却仍把结果转到固定的小 TP group 执行 FFN,超出该 group 的 GPU 因而闲置。这是一种明显不合理的执行安排。
Helix 从 开始扩大 TP group,将参与 Attention 的全部 ranks 纳入同一个 TP group,使 TP degree 变为 Attention 阶段的 KVP×TP。原本在同一 KVP group 内处理不同 KV 序列分片的 ranks,此时分别持有不同的 权重分片。Dense FFN 继续使用这个更大的 TP group,MoE 则将同一批 ranks 组织成 MoE-TP×EP。这样,增加的 GPU 也能继续分摊后续的权重存储与读取。
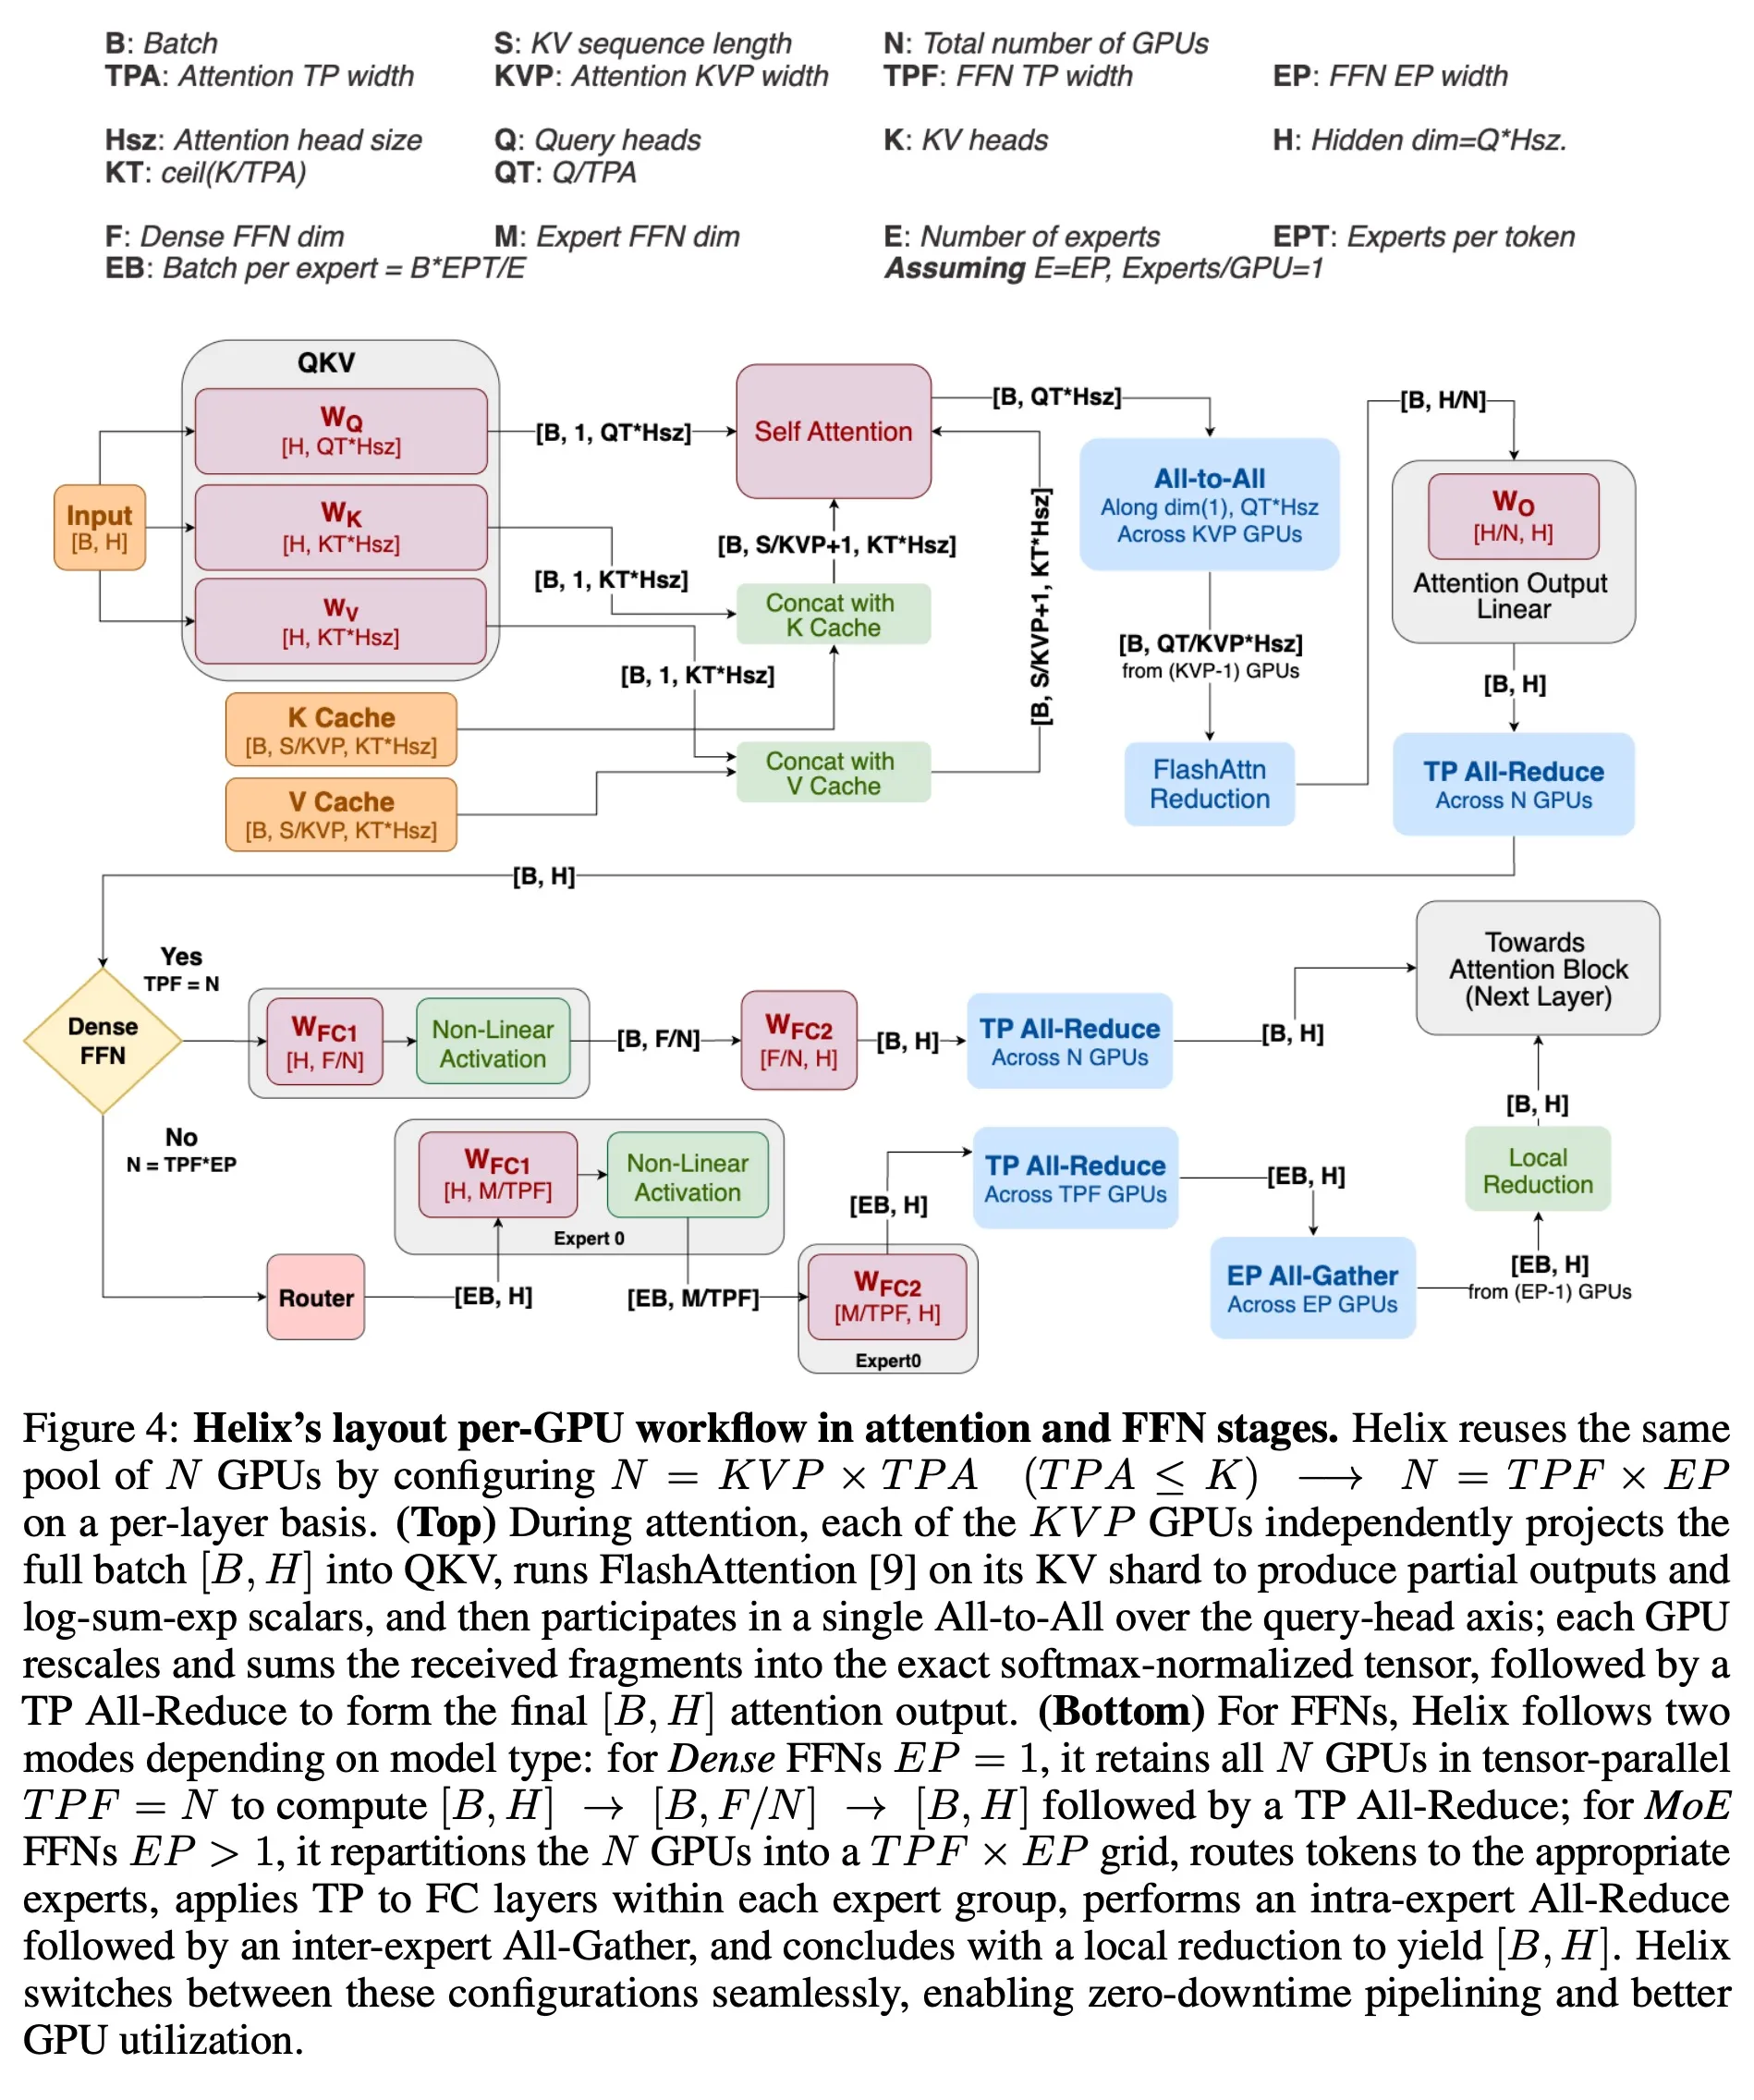
图中 表示 hidden size,对应本文的 。
减少非必要通信
本地计算 ,省去 AllGather
先看 Attention 的输入。同一 KVP group 需要相同的 ,但这些 不一定要通过 AllGather 获得。如果各 rank 持有相同的输入和 分片,就能直接在本地计算。Helix 在 KVP group 内复制由 Attention TP 切分的 //,各 rank 独立计算所需的 //。新生成的 / 按序列位置写入指定 rank 的 Cache,历史 KV Cache 仍保持分片。
这样省去了每个 step 的 Q AllGather,代价是权重的额外存储和读取,以及重复的投影计算。只有省去的通信延迟超过新增的本地执行时间,才有加速收益。
All-to-All:将两次通信合为一次
前文 vLLM 的 ag_rs 先 AllGather LSE,在各 rank 本地计算归并系数,再通过 ReduceScatter 对加权后的局部 求和、分片。这里有两次通信,但接收方最终只需要与本地 分片对应的 ,是否真的有必要先让所有 ranks 都拿到全部 LSE?
只看一个 KVP group,包含 rank 0、1,负责两个 Q heads 和一个 KV head。用 表示 rank 对 head 算出的局部结果, 表示该 head 的完整 Attention 结果:
| rank | 本地 Attention 结果 | 后续 所需 |
|---|---|---|
| 0 | 、:两个 heads 使用前半段 KV 算出的局部结果 | head 0 的完整 Attention 结果 |
| 1 | 、:两个 heads 使用后半段 KV 算出的局部结果 | head 1 的完整 Attention 结果 |
从 开始,Helix 扩大 TP degree,让 rank 0、1 分别持有这两个 heads 对应的权重分片。因此 rank 0 需要 rank 1 算出的 ,rank 1 需要 rank 0 算出的 ,才能分别归并出 、。AG+RS 和 A2A 都能完成这次交换与归并:
| 步骤 | AG+RS | All-to-All |
|---|---|---|
| 第一次通信 | AllGather 两个 heads 在两个 KV 分片上的 LSE | rank 0 将 及其 LSE 发给 rank 1,rank 1 将 及其 LSE 发给 rank 0 |
| 本地计算 | 各 rank 将本地两个 heads 的局部输出乘以归并系数 | rank 0 按 LSE 加权归并 、,得到 ;rank 1 同理得到 |
| 第二次通信 | ReduceScatter 加权输出,求和后将 分给 rank 0、 分给 rank 1 | 无 |
两条路径最终都让 rank 0 得到 、rank 1 得到 。Helix 用一次 All-to-All 同时交换局部输出与 LSE,再由接收方本地归并,替代了 AllGather LSE 和 ReduceScatter 输出这两次通信。
得到所需的 后,两条路径便可继续执行相同的后续计算:各 rank 用自己的 计算 ,再与其他 TP ranks 一起 AllReduce,得到完整 并进入 FFN。
HOP-B:重叠计算与通信
对仍需执行的 All-to-All,Helix 用 HOP-B 将 batch 拆成几批请求,让一批的通信与另一批的 Attention 计算重叠。每批仍按 局部 Attention → All-to-All → 本地归并 执行,但不同批次可以交错推进,减少等待。
根据论文在 GB200 NVL72、FP4、100 万上下文下的实验结果,在相同 Tokens/s/GPU(单位 GPU 输出吞吐)处比较,关闭 HOP-B 后,Llama-405B 的 Tokens/s/User(单用户生成速度,即 TPOT 的倒数)最多下降约 12%,DeepSeek-R1 约下降 1%。这是由于 DeepSeek-R1 的这次 All-to-All 仅占端到端 Decode 延迟约 1%,主要耗时在 MLA 投影和 MoE 计算,因此即使通过重叠隐藏这部分通信,整体收益也有限。
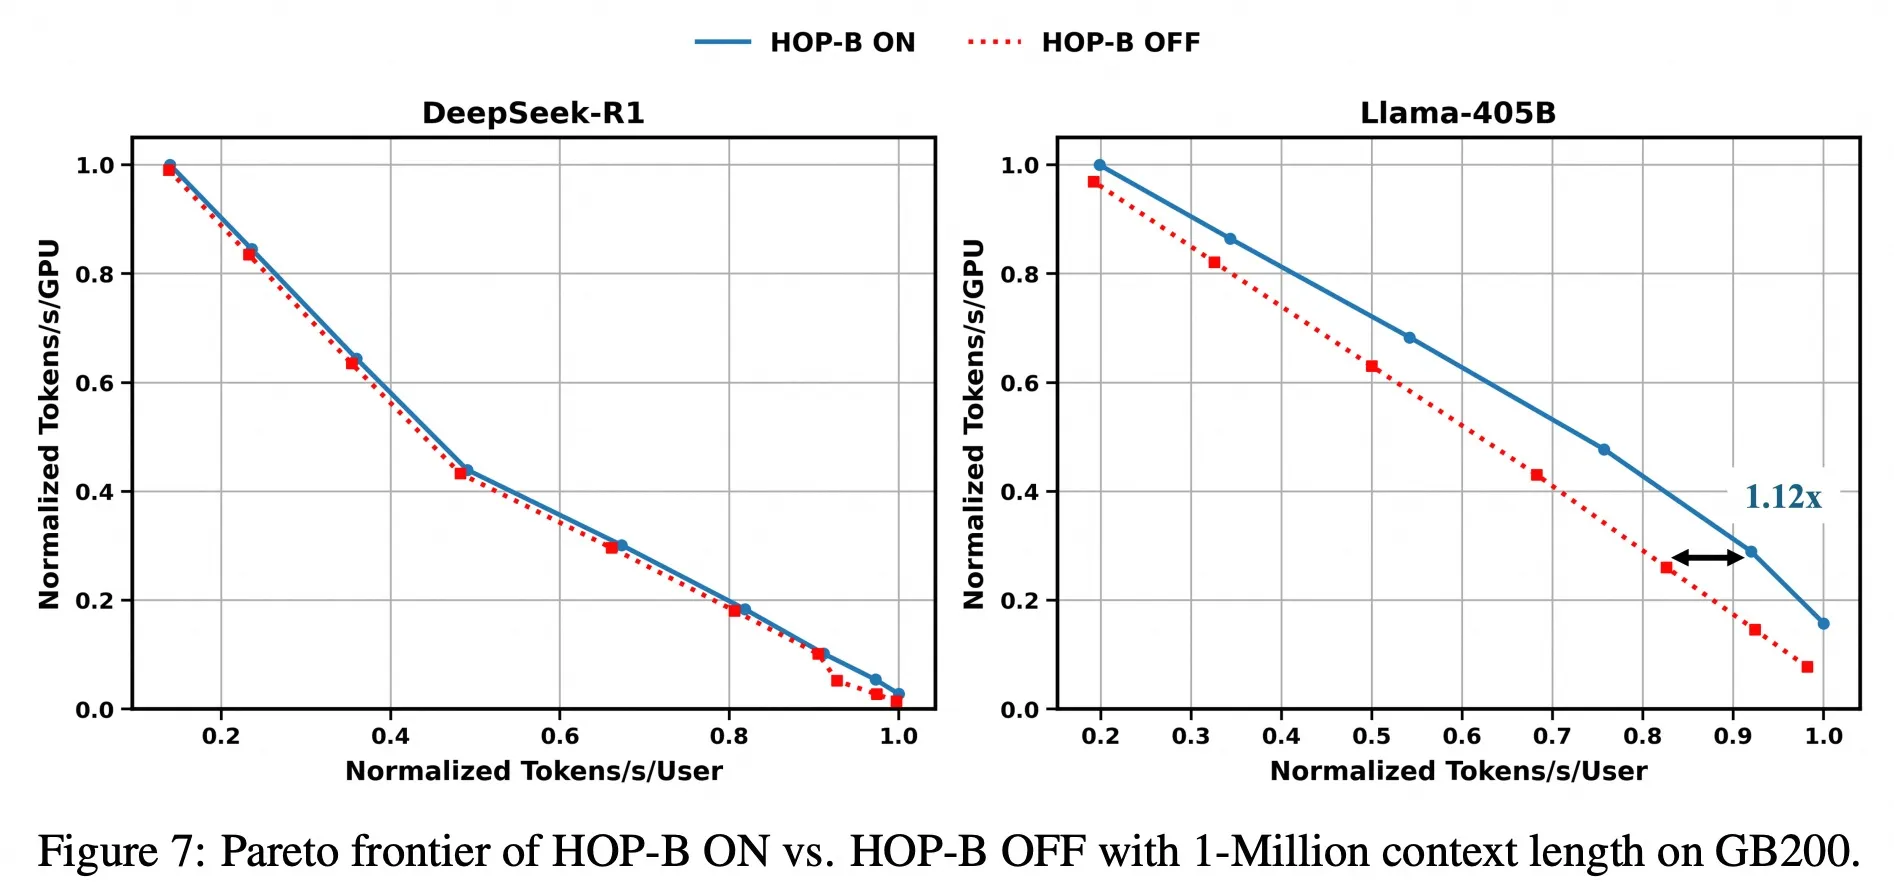
图中横轴为 Tokens/s/User,纵轴为 Tokens/s/GPU。曲线上的点对应不同 batch 和并行配置。
整体效果
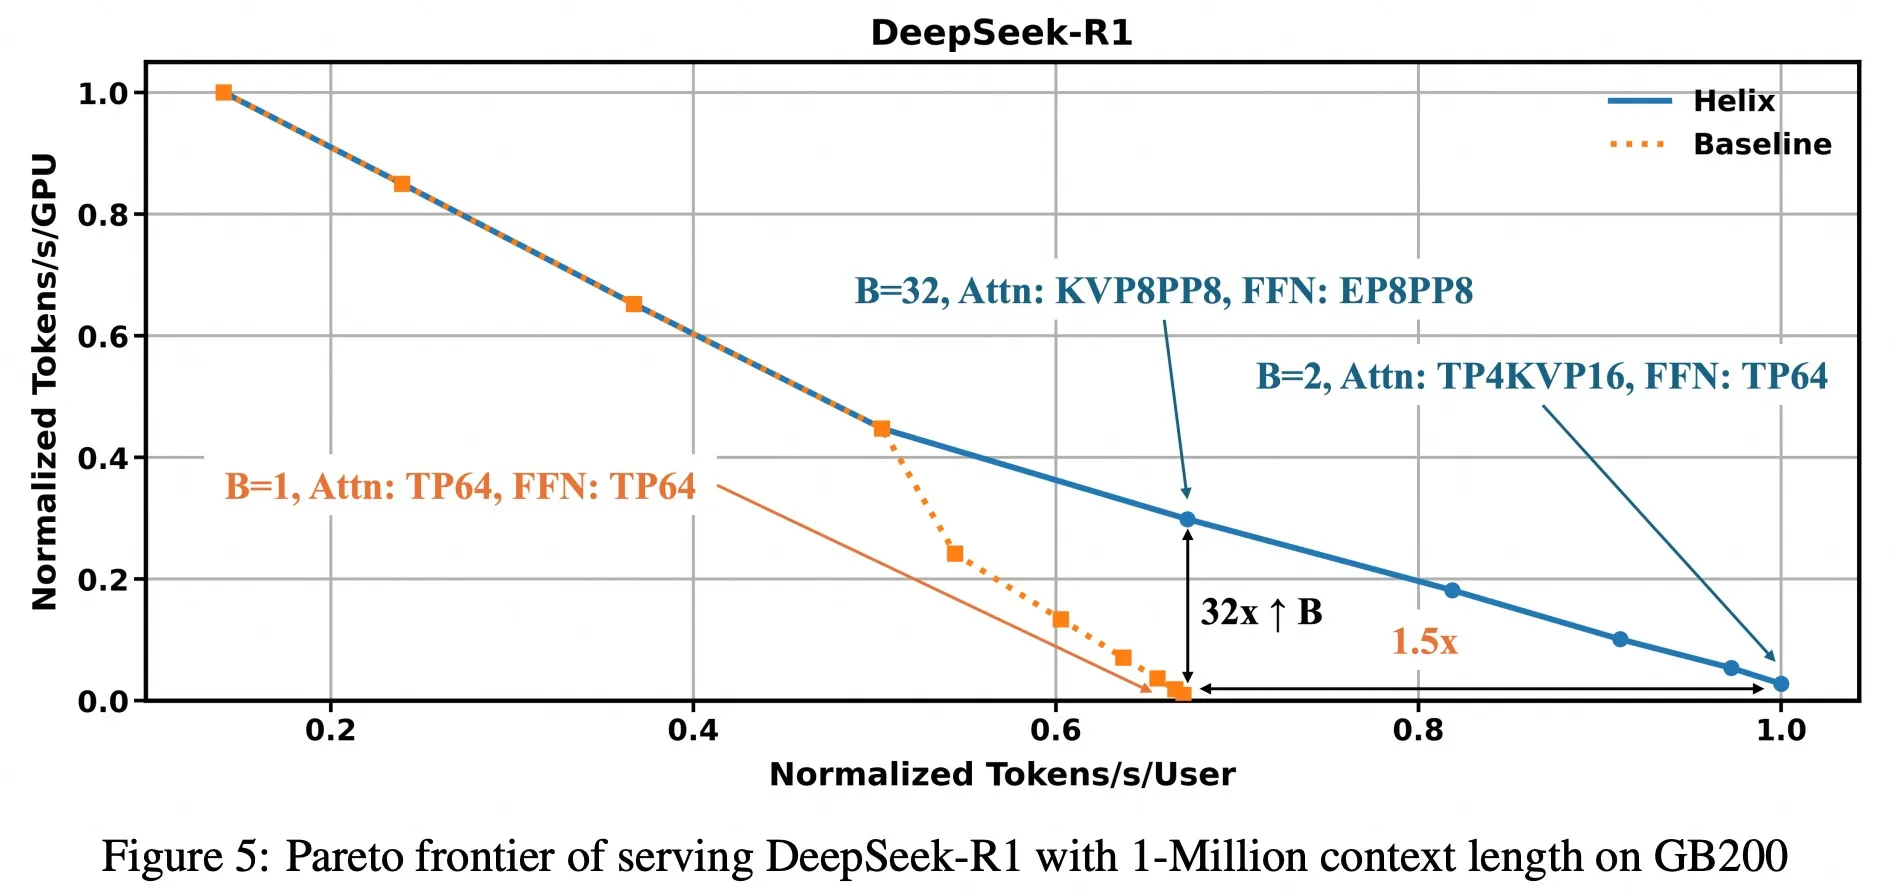
综合前述优化,在上述实验条件下,Helix 将 DeepSeek-R1 的最高 Tokens/s/User 提升到 Baseline 的约 1.5 倍。在相同 TPOT 约束下,可支持的 batch 和 Tokens/s/GPU 最高达到 Baseline 的 32 倍。
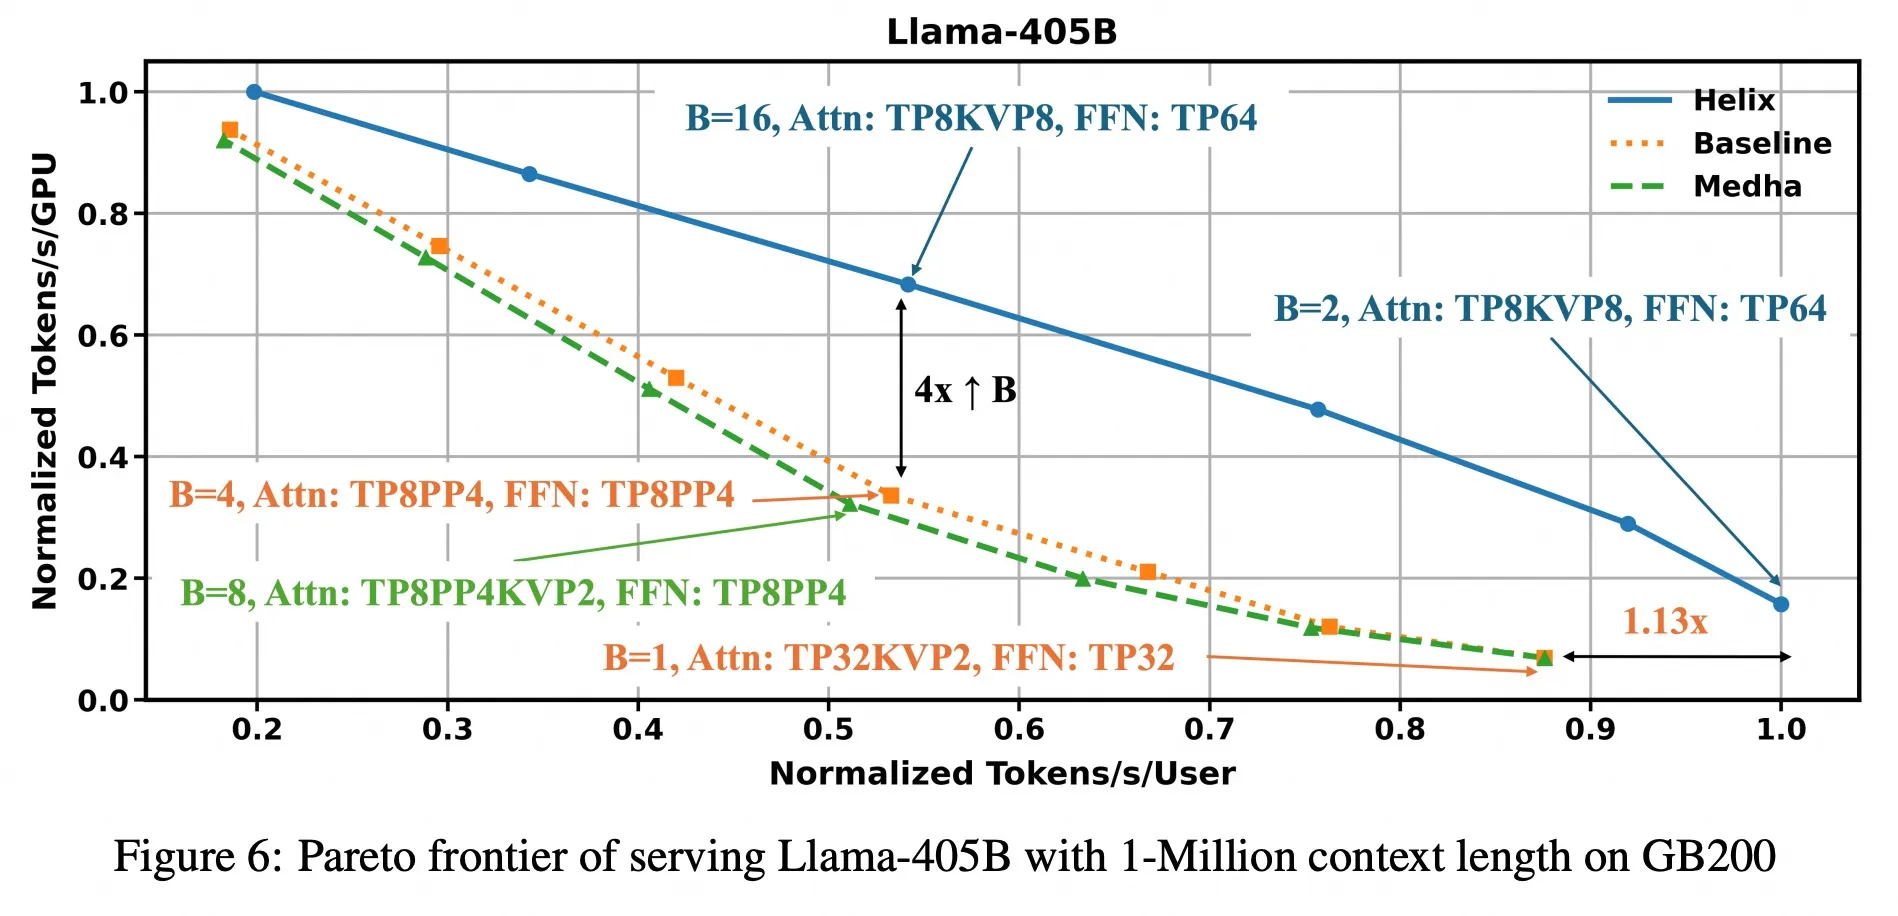
Llama-405B 的最高 Tokens/s/User 则达到 Baseline 的约 1.13 倍。图 6 中间标注的两组配置具有相近的 Tokens/s/User,相比 Baseline,Helix 的 batch 从 4 增到 16,但 GPU 数量也从 32 增到 64,因此虽然总吞吐约为 4 倍,最终 Tokens/s/GPU 约为 2 倍。
总结
并行策略决定各 rank 负责哪些计算,以及权重、激活和 Cache 如何分片或复制。本地数据是否足够、计算结果如何分布,又决定了何时需要通信,以及怎样衔接下一步。即使同样沿序列维切分,固定 、传输 / 的 PCP,与固定 KV Cache、交换 和局部 的 DCP,也会形成不同的数据流。下一步计算若能直接使用本地分片,就无需先恢复完整张量。需要跨 rank 交换或归并时,也应按下一步所需的分片组织通信,让结果直接进入后续计算。若复制部分权重、在本地重复计算能更快得到所需数据,也可以用这部分开销换取更少的通信等待。
满足显存容量要求后,继续增加并行 degree 是否有收益,还需结合理论估算与实测判断。单 rank 的工作量虽然减少了,通信和等待却可能让总延迟上升。因此,选择配置时要计算端到端耗时,包括通信轮次、同步等待和负载不均的影响。aiconfigurator 就是对推理全过程进行定量分析的一种尝试。
参考资料
-
Dao, T., FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning, 2023. arXiv:2307.08691 ↩ ↩2
-
How To Scale Your Model, Sharded Matrices and How to Multiply Them. ↩
-
NVIDIA nccl-tests, Issue #272: H200 AllReduce results ↩ ↩2
-
Yu, G. et al., Orca: A Distributed Serving System for Transformer-Based Generative Models, OSDI 2022. Paper ↩
-
Agrawal, A. et al., Sarathi: Efficient LLM Inference by Piggybacking Decodes with Chunked Prefills, 2023. arXiv:2308.16369 ↩
-
Agrawal, A. et al., Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve, 2024. arXiv:2403.02310 ↩
-
TensorRT-LLM, Helix Parallelism: Scaling Multi-Million-Token Decoding with KV Cache Sharding ↩
-
Liu, H. et al., Ring Attention with Blockwise Transformers for Near-Infinite Context, 2023. arXiv:2310.01889 ↩ ↩2
-
Dao, T. et al., Flash-Decoding for long-context inference, 2023. Article ↩
-
vLLM, DCP attention operations,
cp_lse_ag_out_rs. ↩ -
Brandon, W. et al., Striped Attention: Faster Ring Attention for Causal Transformers, 2023. arXiv:2311.09431 ↩
-
ring-flash-attention, Performance Summary ↩
-
DeepSeek, DeepGEMM: Mega MoE. ↩
-
DeepSeek, Expert Parallelism Load Balancer. ↩
-
NVIDIA, Scaling Large MoE Models with Wide Expert Parallelism on NVL72 Rack Scale Systems, 2025. Article ↩
-
The Mooncake Team, Elastic EP in SGLang: Achieving Partial Failure Tolerance for DeepSeek MoE Deployments, 2026. Article ↩
-
Bhatia, N. et al., Helix Parallelism: Rethinking Sharding Strategies for Interactive Multi-Million-Token LLM Decoding, 2025, §2–3. arXiv:2507.07120v1 ↩